كيف تكوّن عصر الذكاء الاصطناعي؟ ومن يملك مفاتيحه؟
2026-11-09 · A.F. Sadek
من ثورة في طريقة معالجة اللغة عام 2017 إلى أنظمة تكتب وتبحث وتبرمج وتستخدم الأدوات في 2026: رحلة العلم والحوسبة والمال والعمل البشري التي صنعت هذه الصناعة، ومن يتحكم اليوم في تشغيلها وتطويرها.
يغطي هذا المقال الأحداث حتى 17 أكتوبر 2026.
نافذة صغيرة تطل على عالم واسع
نكتب طلبًا في نافذة محادثة، فنحصل على رسالة أو صورة أو برنامج. وقد نعطي النظام مهمة أطول، فيفتح صفحات، ويجمع المصادر، ويعدّل ملفات، ويستخدم أدوات أخرى لإنجازها. الواجهة واحدة تقريبًا، لكن ما يجري خلفها مختلف تمامًا: كتابة إجابة ليست مثل تنفيذ إجراء في حساب مصرفي أو تعديل ملفات مشروع. وبين الحالتين عقود من الأبحاث، وآلاف العاملين، وبنية حوسبة تتطلب استثمارات هائلة.
كيف وصلنا إلى هذه النقطة؟ للإجابة، لا تكفي قائمة بأسماء النماذج وتواريخ إطلاقها. نحتاج إلى فهم ما تغير في طريقة التعلم والحساب، وكيف انتقلت الأبحاث من المختبر إلى السوق، ولماذا أصبح استخدام قدرات متقدمة أسهل بكثير من امتلاك الوسائل اللازمة لصنعها.
بدأ البحث في الذكاء الاصطناعي قبل هذا العصر بوقت طويل. طرح آلان تورينغ أسئلة مبكرة عن سلوك الآلة والذكاء، وحمل مؤتمر دارتموث عام 1956 اسم «الذكاء الاصطناعي» إلى مشروع بحثي ناشئ. توزعت المحاولات بين برمجة قواعد صريحة تحدد للآلة ما تفعله، وبناء أنظمة تتعلم أنماطًا من الأمثلة. لم يلغِ أحد المسارين الآخر؛ بل تغير وزن كل منهما مع تطور الخوارزميات والبيانات والأجهزة.
في الشبكات العصبية، يتعلم النظام بتعديل أعداد داخلية تسمى الأوزان. تحدد هذه الأوزان مقدار تأثير الإشارات بعضها في بعض. يُقارن مخرج الشبكة بالنتيجة المطلوبة، ثم تُحسب الأخطاء ويُستخدم الانتشار العكسي لمعرفة كيف ينبغي تعديل الأوزان لتقليلها. كانت ورقة عام 1986 محطة بارزة في انتشار هذه الطريقة. لكن وجود طريقة للتعلم لا يكفي وحده؛ فلا بد من أمثلة كثيرة وقدرة حسابية لتكرار التدريب مرات هائلة.
وفرت الصور والنصوص والبحث والترجمة كميات متزايدة من البيانات. وأتاحت وحدات معالجة الرسوميات (GPU) تنفيذ عمليات رياضية كثيرة بالتوازي، وهي العمليات التي تحتاج إليها الشبكات العصبية. وقد أظهر AlexNet عام 2012 أثر هذا الاجتماع بوضوح؛ إذ حقق قفزة كبيرة في دقة تصنيف الصور بفضل تصميم الشبكة وتوافر بيانات التدريب وقوة المعالجة. لم يأتِ الإنجاز من خوارزمية منفردة؛ بل من اجتماع عناصر كان يصعب جمعها من قبل.
أما اللغة فكانت أصعب من مجرد التعرف إلى كلمة. معنى الكلمة يتغير بموقعها وبالكلمات المحيطة بها. بدأت الأنظمة تتعلم تمثيلات رقمية للكلمات تقرّب الكلمات المستخدمة في سياقات متشابهة، ثم استخدمت الشبكات العصبية الراجعة وLSTM للاحتفاظ بمعلومات من الكلمات السابقة أثناء معالجة الجملة. وفي الترجمة، استخدمت نماذج التسلسل إلى التسلسل شبكة لفهم الجملة وأخرى لإنتاج ترجمتها. وأضاف Bahdanau وزملاؤه آلية تتيح للنموذج الرجوع إلى أجزاء مختلفة من النص الأصلي عند توليد كل جزء من الترجمة. هنا ظهرت فكرة الانتباه التي ستكتسب دورًا مركزيًا بعد سنوات قليلة.
وفي مسار مختلف، جمع AlphaGo بين التعلم والبحث داخل احتمالات اللعب ليهزم كبار لاعبي «غو». يوضح نجاحه أن أبحاث الذكاء الاصطناعي لم تكن تنتظر ظهور المساعد اللغوي؛ فقد كانت تحقق نتائج كبيرة بطرق متنوعة وفي مهام مختلفة.
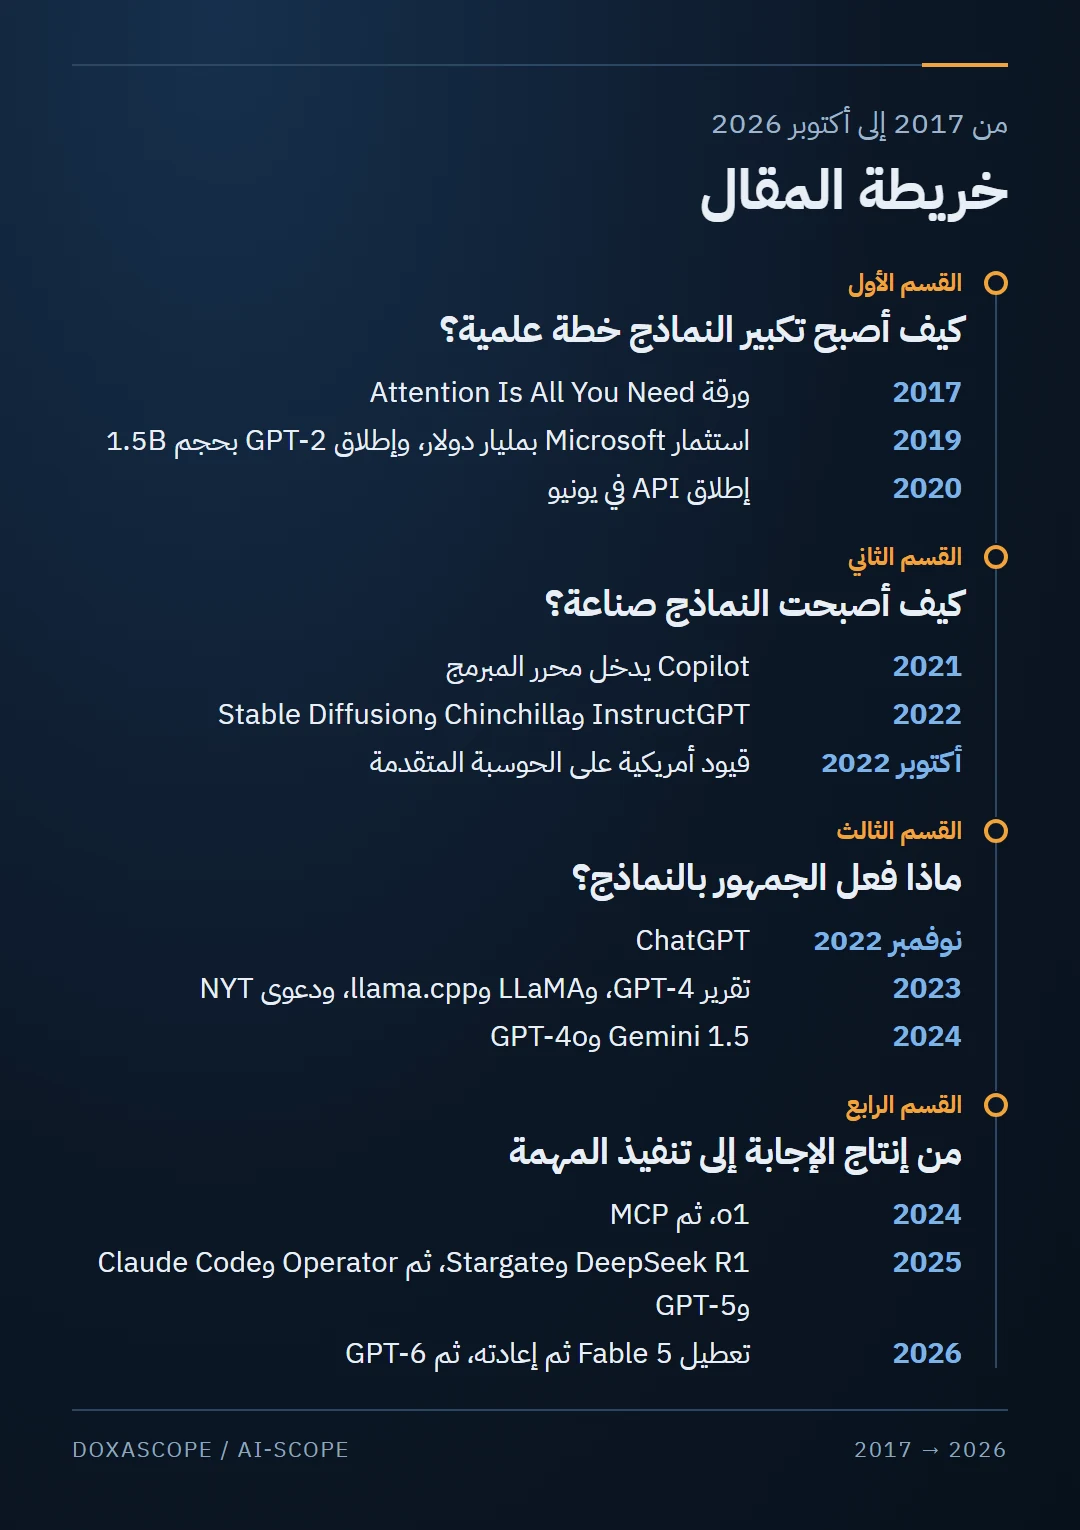
القسم الأول: كيف أصبح تكبير النماذج خطة علمية؟
2017: معالجة اللغة بالتوازي
في 2017، قدم باحثون ورقة Attention Is All You Need، التي عرّفت بنية Transformer. كانت الشبكات الراجعة تعالج الجملة أثناء التدريب في خطوات متتابعة؛ فتعتمد معالجة الكلمة التالية على نتائج الخطوة السابقة. أما Transformer فاستبدل هذا التسلسل في حساب تمثيلات النص بآلية الانتباه الذاتي: يحسب النظام، لكل موضع في النص، درجة صلته بمواضع أخرى، ثم يستخدم هذه العلاقات لبناء تمثيل أغنى للسياق.
خذ جملة مثل «وضعت سارة الكتاب على الطاولة ثم أخذته». لفهم المقصود بـ«أخذته»، يحتاج النظام إلى ربط الضمير بكلمة «الكتاب»، لا بمجرد قراءة الكلمات منفصلة. يساعد الانتباه على بناء مثل هذه الروابط. وتُضاف إلى الحساب معلومات عن ترتيب الكلمات، حتى لا تتساوى الجمل لمجرد احتوائها على الكلمات نفسها.
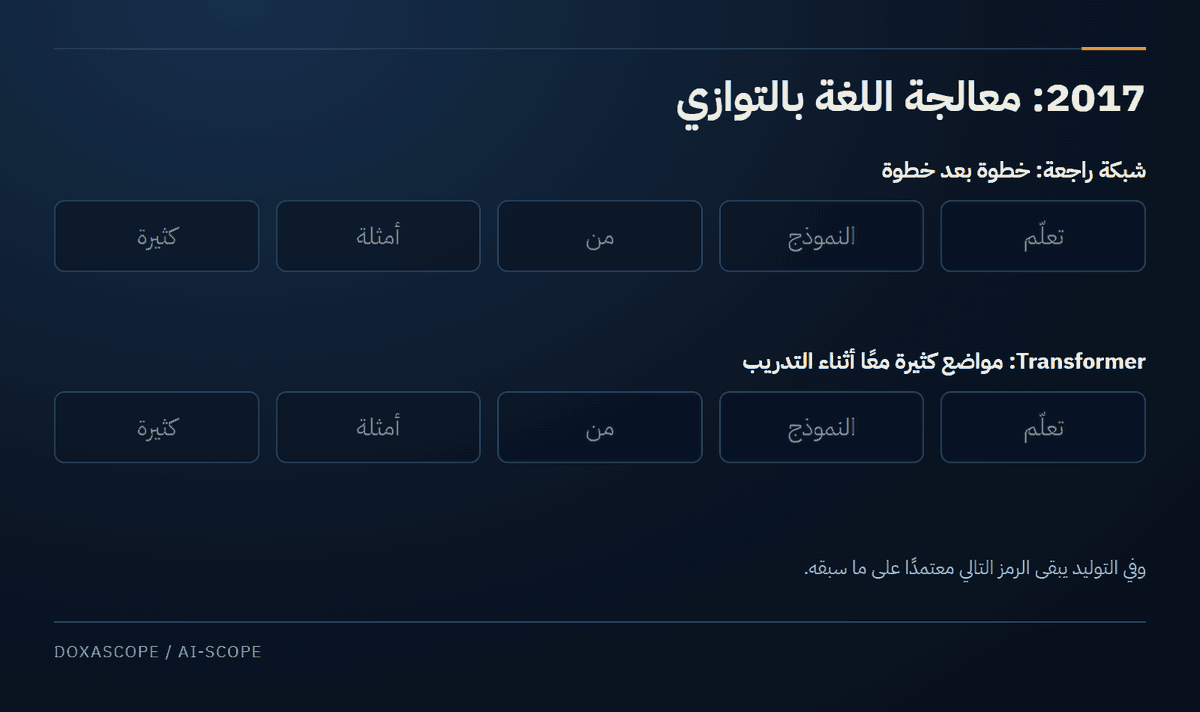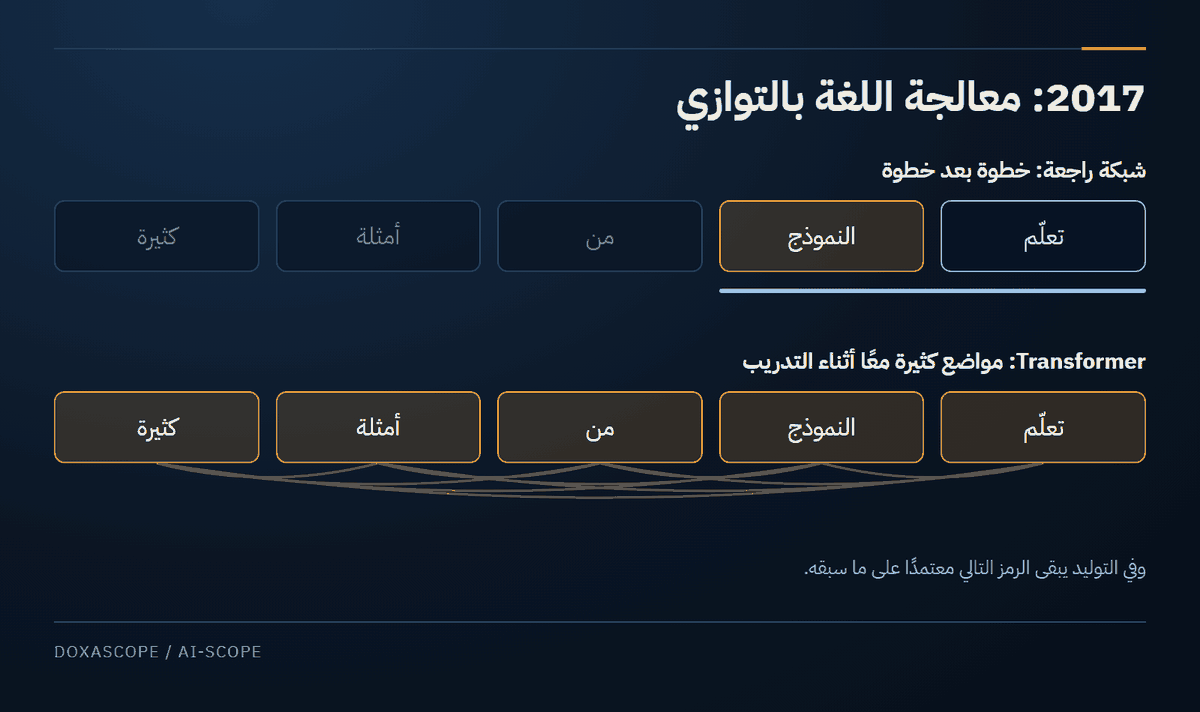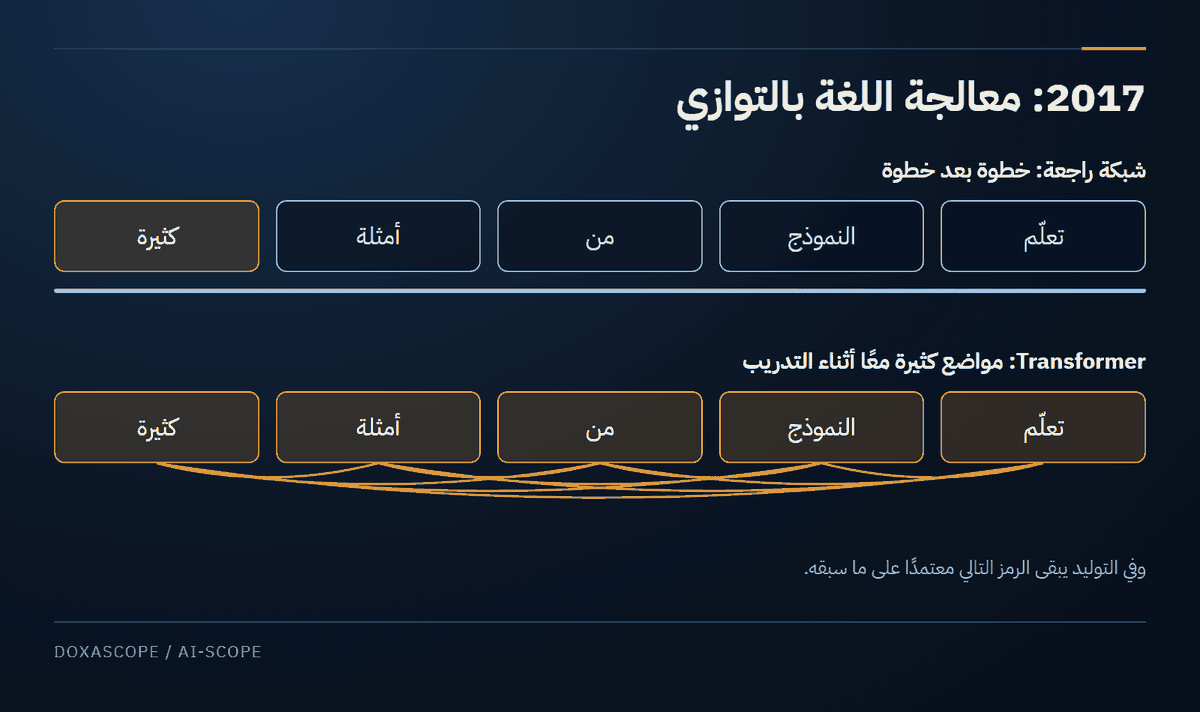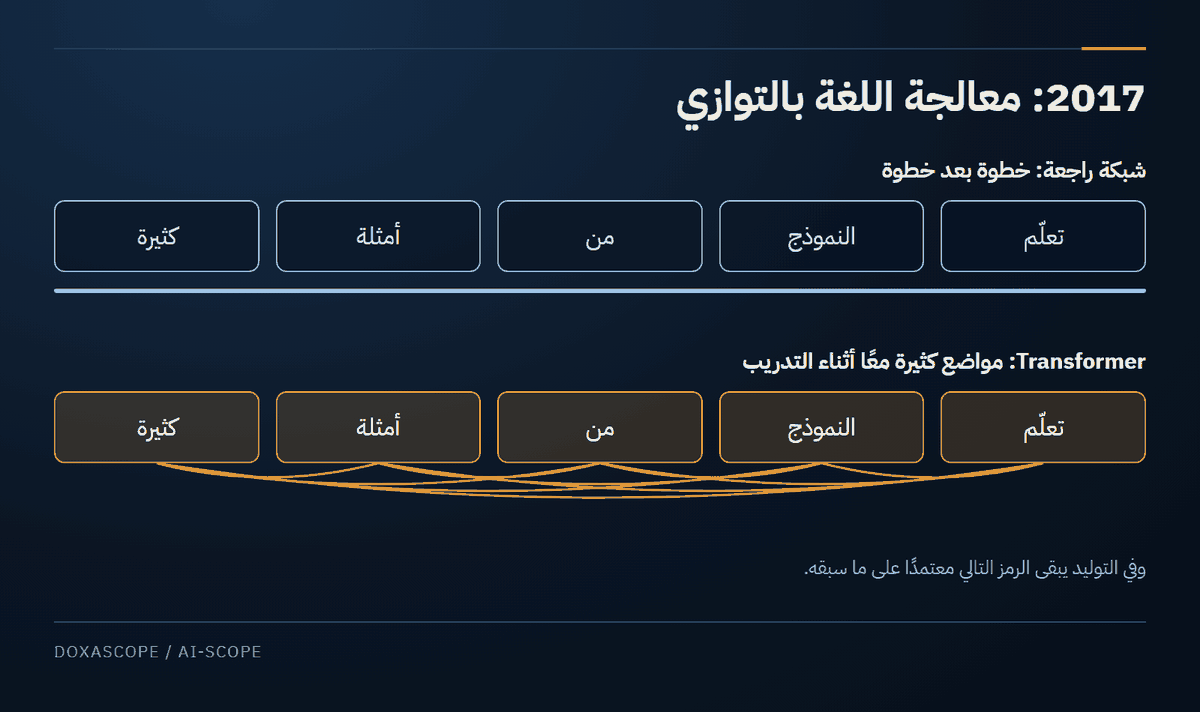
الأثر الحاسم كان هندسيًا أيضًا. صار من الممكن معالجة مواضع كثيرة من النص في الوقت نفسه أثناء التدريب، بما يستفيد من المعالجات المتوازية. لم يجعل ذلك الحساب مجانيًا: الانتباه نفسه مكلف، كما أن توليد النص بالطريقة المعتادة يظل متتابعًا؛ ينتج النموذج جزءًا جديدًا بعد الأجزاء السابقة. لكن تحسين الاستفادة من الأجهزة فتح الباب لتدريب شبكات أكبر على بيانات أكثر.
كان العتاد يتطور بالتزامن. قدمت NVIDIA معمارية Volta ووحدات Tensor Cores المتخصصة في العمليات المصفوفية، وطورت Google وحدات TPU وأنظمة تضم أعدادًا كبيرة منها. ثم أصبحت سرعة الاتصال بين الشرائح وتقسيم الأحمال عليها جزءًا من تصميم أنظمة التدريب. وفي الوقت نفسه واصل AlphaZero تطوير نهج التعلم والبحث للألعاب؛ فلم تكن كل أبحاث الذكاء الاصطناعي تسير على طريق النماذج اللغوية.
2018–2019: طرق مختلفة لتعليم الآلة اللغة
لم يتفق الباحثون فورًا على طريقة واحدة. جعل ELMo تمثيل الكلمة يتغير بحسب سياقها. ودُرّب GPT-1 على توقع الكلمة التالية، ثم عُدّل لأداء مهام لغوية محددة. أما BERT فتعلم من النص في الاتجاهين، مستفيدًا من الكلمات السابقة واللاحقة للتنبؤ بكلمات مخفية. وجرّب XLNet صياغة مختلفة للاستفادة من السياق أثناء التدريب.
كانت هذه الاختيارات تخدم أهدافًا متباينة. فالبحث عن إجابة داخل فقرة، وتصنيف رسالة، وترجمة جملة، وتأليف نص جديد ليست مهمة واحدة. ويمكن لنموذج أن يتفوق في واحدة ويتأخر في أخرى. ولهذا لم تكن المنافسة بين BERT وGPT إعلانًا مبكرًا عن فائز نهائي؛ بل اختبارًا لمسارات تدريب مختلفة. وتضمنت ورقة GPT-1 تجارب محدودة بلا أمثلة تدريب إضافية، لكن نتائجها الرئيسية جاءت من تعديل النموذج لمهام بعينها.
وفي 2019 أثار GPT-2 سؤالًا جديدًا إلى جانب الجودة: من يحصل على النموذج نفسه؟ أطلقت OpenAI نسخًا أصغر أولًا وأخرت إتاحة النسخة الأكبر، التي تضم نحو 1.5 مليار معامل، ثم نشرتها في نوفمبر 2019. كانت الشركة تعلن اعتبارات تتعلق بمخاطر الاستخدام؛ وفي الوقت ذاته أظهر القرار أن الجهة التي تدرب النموذج تستطيع تحديد موعد إتاحته ومن يحق له استخدامه.
2019–2020: البيانات والحوسبة تتحولان إلى صناعة
جاء T5 بفكرة عملية: تحويل أنواع كثيرة من المهام إلى صيغة «نص يدخل، ونص يخرج». ويمكن استخدام هذا الإطار للترجمة والتلخيص والإجابة عن الأسئلة بتغيير صياغة الطلب والبيانات. واعتمد المشروع على مجموعة C4، المبنية من صفحات ويب جرى جمعها وتصفيتها وتنظيفها. لم تكن بيانات التدريب مادة خام محايدة؛ فاختيار الصفحات واللغات واستبعاد المحتوى المكرر أو غير المرغوب فيه يغير ما يتعلمه النموذج.
وفي يوليو 2019 أعلنت OpenAI عن استثمار من Microsoft بقيمة مليار دولار وشراكة لاستخدام Azure. ظهرت في السنوات نفسها تقنيات مثل Megatron-LM وZeRO لتوزيع العمل والذاكرة على عدد كبير من المعالجات. فالنموذج الكبير لا يتطلب قدرة حسابية فحسب؛ بل طريقة لتخزين أوزانه ونتائج الحساب المرحلية وتحديثاته عبر أجهزة متعددة.
ثم جاءت قوانين التوسع. درس الباحثون كيف يتغير خطأ النموذج عند زيادة عدد المعاملات وكمية البيانات والحساب المستخدم في التدريب. ووجدوا علاقات تجريبية تساعد على تقدير العائد من تكبير النموذج قبل إنفاق ميزانية التدريب كاملة. لم تكن القوانين وصفة مضمونة للذكاء العام؛ لكنها جعلت قرار الإنفاق على نماذج أكبر أكثر قابلية للحساب.
قدم GPT-3 مثالًا لافتًا على النتيجة. بدل تعديل أوزان النموذج كلما طلبنا مهمة جديدة، أمكن إعطاؤه تعليمات وأمثلة داخل الطلب نفسه؛ مثل عرض ثلاث جمل مترجمة ثم طلب ترجمة الرابعة. وفي يونيو 2020 أطلقت OpenAI واجهة برمجية (API) تتيح للمطورين استخدام نماذجها عن بُعد. لم يعد مطلوبًا من كل شركة شراء أجهزة لتدريب نموذج كبير؛ لكنها أصبحت تعتمد على خدمة تحدد أسعار الاستخدام وشروطه وحدوده. وفي سبتمبر 2020 أعلنت Microsoft اتفاقًا للترخيص التجاري الحصري لتقنية GPT-3، قبل أن تتغير ترتيبات الشراكة في السنوات التالية.
القسم الثاني: كيف أصبحت النماذج صناعة؟
ما الذي لا تخبرنا به أعداد المعاملات؟
كثيرًا ما تقدم الأخبار نموذجًا جديدًا برقم ضخم من «المعاملات»، لكن عدد المعاملات وحده لا يحدد ما يمكن تشغيله. في التدريب، تُخزَّن الأوزان، وتُحسب التحديثات، ويُحتفظ بنتائج وسيطة يحتاجها الانتشار العكسي. وقد تتجاوز هذه البيانات ذاكرة جهاز واحد بمراحل. وحتى عند توزيعها على أجهزة كثيرة، يصبح نقلها بين المعالجات عنق زجاجة: من ينتظر البيانات لا يستطيع مواصلة الحساب.
لهذا دخلت تقنيات الشبكات السريعة، ومنها منتجات Mellanox، ومعالجات مثل A100، وبرمجيات التدريب الموزع، في صميم صناعة النماذج. وقدمت ZeRO طريقة لتقليل النسخ المكررة من حالة النموذج أثناء التدريب، أي الأوزان والتدرجات وحالات المحسِّن، التي تحتفظ بها الأجهزة. كل ذاكرة نوفرها وكل عملية نقل نتجنبها تسمح بتدريب نموذج أكبر أو استخدام أجهزة أقل. وصار السؤال الاقتصادي ملازمًا للسؤال العلمي: كم يكلف تدريب النموذج، وكم يكلف تشغيله لكل مستخدم بعد ذلك؟
في المقابل، ظهرت محاولات لبناء نماذج ومجموعات بيانات خارج الشركات المهيمنة. ساعد مشروع The Pile على توفير مجموعة نصوص واسعة للبحث، وتبعتْه نماذج مثل GPT-Neo وGPT-J وGPT-NeoX. واستمرت المختبرات الكبرى في تجارب التوسع، ومنها Gopher وMegatron-Turing وSwitch Transformer. والأخير استخدم نهج الخبراء المتخصصين: يضم النموذج أجزاء متعددة، لكنه لا يشغّلها كلها بالطريقة نفسها لكل جزء من النص؛ بل يختار أجزاء محددة بحسب المدخلات. بذلك يمكن زيادة الحجم الكلي للنموذج من دون زيادة مماثلة في الحساب المستخدم لكل خطوة.
وفي 2020 ظهرت صياغة بحثية مهمة هي التوليد المعزز بالاسترجاع (RAG). الفكرة بسيطة: بدل مطالبة النموذج بالإجابة مما تعلمه أثناء التدريب وحده، يبحث النظام أولًا عن وثائق مرتبطة بالسؤال، ثم يضع مقتطفات منها ضمن مدخلات النموذج. إذا سأل موظف عن سياسة شركة تغيرت أمس، يستطيع النظام استرجاع النسخة الجديدة بدل الاعتماد على معرفة قديمة مخزنة في الأوزان. هذا لا يضمن صحة الجواب تلقائيًا؛ بل يوفر مادة يمكن الرجوع إليها وفحصها. الورقة الأصلية سبقت موجة المساعدين المتصلين بالملفات ومحركات البحث بسنوات.
2021: الذكاء الاصطناعي يدخل أدوات العمل
مع GitHub Copilot، لم يعد توليد البرامج محصورًا في عرض تقني أو صفحة دردشة. أصبح الاقتراح يظهر داخل محرر الكود نفسه، بينما يكتب المبرمج دالة أو تعليقًا أو اختبارًا. وتتضح هنا طبيعة الأداة الجديدة: يمكنها إنتاج جزء من الحل بسرعة، لكن المبرمج ما زال مسؤولًا عن التأكد من أنه يعمل، ولا يحتوي على أخطاء أمنية، ويؤدي المطلوب فعلًا.
وأظهرت ورقة Codex أهمية المحاولات المتعددة. قد يفشل اقتراح واحد في حل مسألة برمجية، بينما تنجح إحدى عشرات المحاولات عند اختبارها. لكن اختبار مئة اقتراح واختيار الصحيح عمل مختلف عن الحصول على إجابة صحيحة من المحاولة الأولى. لهذا لا تشرح النسبة المعلنة في اختبار ما تجربة جميع المستخدمين.
وتزامن ذلك مع تحسين طرق تكييف النماذج. قدمت LoRA أسلوبًا لتعديل عدد صغير نسبيًا من المعاملات الإضافية بدل إعادة تدريب جميع أوزان النموذج الكبير. أما FLAN فركز على التدريب باستخدام تعليمات متنوعة لتحسين قدرة النموذج على اتباع طلبات جديدة، وتقدم LaMDA في مسار بناء نماذج مخصصة للحوار. وفي الصور ربط CLIP بين الأوصاف النصية والصور، بينما عرض DALL·E إمكان توليد صور من وصف مكتوب. كانت اللبنات الأساسية لمنتجات الأعوام التالية تتشكل بالفعل.
العمل البشري وراء المساعد الذي يفهم التعليمات
هناك فرق بين نموذج تعلّم إكمال النص ونموذج يجيب عن طلب المستخدم بوضوح ويلتزم بصيغته. في بحث InstructGPT، كتب عاملون بشريون أمثلة لإجابات مرغوبة، ثم قارنوا إجابات مختلفة ورتبوها. استُخدمت هذه الأحكام لبناء نظام تقييم يتعلم تفضيلات المقيمين، ثم لتحسين إجابات المساعد عبر التعلم المعزز: يحصل النموذج على إشارة مكافأة للإجابات الأعلى تقييمًا، ويُحدّث سلوكه لزيادة احتمال إنتاج إجابات مشابهة. وتبين في اختبارات البحث أن المقيّمين فضّلوا إجابات نموذج أصغر خضع لهذه العملية على إجابات نموذج أكبر لم يخضع لها بالطريقة نفسها.
هذا يفسر جزءًا من التحول الذي سيظهر للجمهور مع ChatGPT: لم يصبح النموذج قادرًا على بناء الجمل فحسب، بل صار أكثر استعدادًا لفهم صيغة الأمر، والاعتراف بأخطائه، ورفض الطلبات غير المناسبة، واتباع نمط محادثة مألوف. كان وراء ذلك عمل بشري في كتابة الأمثلة والحكم على الجودة، لا حساب آلي مستقل وحده. وما اعتبره المقيمون إجابة مناسبة تأثر بطبيعة التعليمات والمعايير المطبقة عليهم.
وفي ديسمبر 2022، قدّمت Anthropic مسارًا آخر في بحث الذكاء الاصطناعي الدستوري (Constitutional AI). يراجع النموذج إجاباته وفق مجموعة مبادئ مكتوبة، ويعيد صياغتها، ثم تُستخدم تقييمات مولّدة بواسطة نموذج في تحسين تدريبه. الهدف هو تقليل الحاجة إلى تقييم بشري مباشر لكل إجابة، مع بقاء اختيار المبادئ نفسها قرارًا بشريًا.
ومن الضروري هنا الفصل بين الوظائف المختلفة. العاملون الذين كتبوا الأمثلة وقارنوا الإجابات في مشروع InstructGPT ليسوا بالضرورة الأشخاص أنفسهم الذين تناولهم تحقيق مجلة TIME عن تصنيف نصوص مؤذية في كينيا. عرض التحقيق شهادات عن التعرض لمحتوى قاسٍ أثناء إعداد بيانات السلامة، إلى جانب موقف الشركة من هذه العمليات. يجمع المسارين اعتمادُ النماذج على بشر خلف الواجهة، لكن طبيعة العمل وظروفه ومسؤولياته مختلفة.
2022: ليس النموذج الأكبر هو الأفضل دائمًا
كان الاتجاه السائد هو زيادة عدد معاملات النموذج، لكن Chinchilla أظهر أهمية توزيع ميزانية التدريب بطريقة مختلفة. فبدل تدريب نموذج بالغ الضخامة على كمية محدودة نسبيًا من النصوص، يمكن إنفاق الميزانية نفسها على نموذج أصغر يقرأ بيانات أكثر أثناء التدريب، ويحصل على نتيجة أفضل في المقاييس التي اختبرها الباحثون. لم تكن النتيجة وقف تكبير النماذج؛ بل إعادة حساب النسبة بين حجم النموذج وكمية البيانات والحوسبة.
وفي 2022 توسعت إمكانات العتاد مع H100 وأنظمة TPU v4. وقدمت FlashAttention تحسينًا مهمًا لا يقوم على اختراع «انتباه» جديد، بل على تنظيم العمليات بحيث تنتقل بيانات أقل بين الذاكرة السريعة والبطيئة. في كثير من الحسابات، نقل البيانات أبطأ وأغلى من العملية الرياضية نفسها. تقليل هذه الحركة يسرّع التنفيذ ويخفض استهلاك الذاكرة، مع بقاء متطلبات الحساب الأساسية للنموذج.
اتسعت كذلك محاولات إتاحة النماذج للبحث والتجربة، ومنها OPT وBLOOM، الذي شارك في تطويره باحثون من مؤسسات متعددة. وفي مسار آخر، اختبرت دراسات Chain-of-Thought قدرة النماذج على الاستفادة من خطوات وسيطة مكتوبة قبل الإجابة النهائية، وقدمت ReAct نهجًا يتبادل فيه النظام التفكير والخطوات العملية، مثل استخدام أداة أو الرجوع إلى مصدر. سبقت هذه الأفكار وكلاء الذكاء الاصطناعي التجاريين، ولم تكن تجاربها المبكرة بمستوى المنتجات التي ظهرت لاحقًا.
2022: الصور تخرج من المختبر
لم يكن التحول مقتصرًا على النصوص. فقد أتاحت خدمات مثل Midjourney إنتاج صور من أوصاف قصيرة، بينما أتاح نشر أوزان Stable Diffusion تشغيل نموذج لتوليد الصور وتعديله خارج الخدمة الأصلية. جاء ذلك بعد مسار من الأبحاث شمل DDPM وCLIP وDALL·E وDALL·E 2 وتقنيات الانتشار الكامن (Latent Diffusion).
ولفهم الفكرة، تخيل صورة تتحول تدريجيًا إلى ضوضاء. تتعلم نماذج الانتشار العملية المعاكسة: تبدأ من ضوضاء وتزيلها على مراحل حتى تظهر صورة تتوافق مع الوصف المطلوب. وبدل إجراء جميع الخطوات على الصورة الكاملة، يعمل Stable Diffusion على تمثيل مضغوط لها، ما يقلل الحساب المطلوب. وقد أتاح نشر أوزان الإصدار 1.4 للمطورين بناء واجهات وأدوات إضافية وتشغيل النموذج على عتاد مناسب، وفق شروط الترخيص.
ترتب على ذلك تحول في العلاقة بين المستخدم والتقنية. فبعض المستخدمين صار بإمكانهم الاحتفاظ بنسخة من النموذج وتعديل طريقة تشغيلها، بدل إرسال كل طلب إلى خدمة بعيدة. وفي المقابل، ظهرت نزاعات حول استخدام أعمال الفنانين في بيانات التدريب، وحقوق المبدعين، ونسبة الأعمال الناتجة إلى أصحابها. لم يكن الفنانون مجرد جمهور يستقبل التقنية؛ كانوا جزءًا من المادة التي تعلمت منها الأنظمة، ومن سوق استخدامها، ومن الجدل حول قواعدها.
وفي التعرف إلى الصوت، أطلقت OpenAI نموذج Whisper، الذي ساعد على تحويل الكلام إلى نص عبر لغات متعددة. كانت الصور والكلام والنصوص تتقارب في المنتجات، حتى وإن اختلفت التقنيات التي تتعامل مع كل منها.
2022: الرقائق تدخل الحسابات السياسية
في أكتوبر 2022، فرضت الولايات المتحدة ضوابط جديدة على تصدير بعض المعالجات المتقدمة ومعدات صناعة أشباه الموصلات، مع مواعيد نفاذ مختلفة في 7 و12 و21 أكتوبر. لم تعد القدرة على شراء أدوات تدريب النماذج الكبيرة مسألة ميزانية ومواصفات فحسب؛ بل دخلت فيها قيود مرتبطة بالدولة والجهة المستفيدة والاستخدام المقصود.
أصبحت رقائق الحوسبة ووسائل تصنيعها جزءًا من المنافسة الصناعية والأمنية بين الدول. وأثرت القيود في الخيارات المتاحة للشركات والباحثين داخل الأسواق المشمولة بها. لكن وجود قيد على شريحة محددة لا يثبت وحده أن تصميم نموذج بعينه جاء نتيجة مباشرة لهذا القيد. سيكون هذا التفريق مهمًا عند تناول قصة DeepSeek لاحقًا.
القسم الثالث: ماذا فعل الجمهور بالنماذج؟
نوفمبر 2022: المحادثة تصبح باب الدخول
في 30 نوفمبر 2022، أطلقت OpenAI خدمة ChatGPT في صورة محادثة يمكن استخدامها مجانًا خلال مرحلتها البحثية. لم يكن النموذج اللغوي اختراعًا بدأ في ذلك اليوم، لكن طريقة الوصول إليه تغيرت جذريًا. لم يعد المستخدم بحاجة إلى كتابة برنامج يتصل بواجهة برمجية، أو فهم إعدادات نموذج بحثي. يكفي أن يكتب سؤالًا بلغة عادية، ويتابع الحديث كما يفعل مع شخص يساعده في مهمة.
كانت سهولة الوصول إلى الأداة نقطة التحول التي جذبت الجمهور. استطاع مبرمج طلب شرح رسالة خطأ، ومدرس تجربة إعداد درس، وكاتب مراجعة فقرة، عبر الواجهة نفسها. وفي المقابل، اتضح مبكرًا أن الطلاقة في الإجابة لا تعني صحتها، وأن جودة الأداء تختلف باختلاف اللغة ونوع المهمة.
في 2 ديسمبر 2022، كتب مبرمج عن تجربة أثناء حل تحدٍّ في مسابقة Advent of Code. طلب من ChatGPT جدولًا يساعده على حساب نتائج لعبة «حجر، ورقة، مقص». بدا الرد مرتبًا، لكن الجدول اعتبر بعض الحركات المختلفة تعادلًا. لاحظ المبرمج الخطأ لأنه يعرف قواعد اللعبة، فاعترض، واعترف النظام بخطئه وقدم جدولًا مصححًا. كانت الأداة مفيدة في عمل صغير، لكن اكتشاف خطئها احتاج إلى إنسان يعرف ما يبحث عنه.
وفي 27 ديسمبر 2022، نشر مستخدم في منتدى مطوري OpenAI أنه طلب قصة بالعربية ووجد أخطاء إملائية كثيرة، وعرض المساعدة في تحسين الخدمة. أما في فبراير 2023، فحكى مدوّن عربي أنه لم يتمكن في البداية من الوصول إلى الخدمة من بلده. وحين استطاع تجربتها وطلب مقالًا عن المراهقة، رأى ابنه التلميذ النتيجة وقال إنها ستنجز واجباته. كان المدوّن يفكر في أثرها على التعليم، فيما رأى الابن اختصارًا فوريًا للواجب المدرسي. تظهر الشهادات الثلاث التفاوت الذي أخفته أرقام الانتشار: إجابات نافعة لكنها تخطئ، ولغات لا تحظى بالجودة نفسها، ومستخدمون يختلفون في فهم ما ينبغي فعله بالأداة.
ثم توسع المنتج تجاريًا. أُطلق اشتراك ChatGPT Plus، وظهرت واجهات برمجية لنماذج المحادثة، ومنها gpt-3.5-turbo الذي جاء بعد نموذج الإطلاق الأصلي. وانتشر تقدير أن الخدمة بلغت مئة مليون مستخدم نشط شهريًا في يناير 2023؛ وهو تقدير من محللي UBS استند إلى بيانات Similarweb.
أوائل 2023: الذكاء الاصطناعي يدخل محرك البحث
بدأت الشركات الكبرى إعادة تشكيل منتجاتها. ظهرت تجربة Bing المبنية على المحادثة، التي ارتبطت باسم Sydney أثناء الاختبارات، ثم Bard من Google وClaude من Anthropic، إلى جانب PaLM 2. لم يعد السؤال كيف يجيب النموذج وحده، بل كيف يغير تجربة البحث واستخدام الخدمات القائمة، وكيف يُدمج في منتجات يستخدمها ملايين الأشخاص أصلًا.
وفي مارس 2023 أعلنت OpenAI نموذج GPT-4. أثار التقرير التقني اهتمامًا واسعًا بنتائج الاختبارات، لكنه لم يكشف تفاصيل محورية عن عدد المعاملات وتصميم النموذج الكامل وبيانات التدريب والحساب المستخدم. هنا اتسعت الفجوة بين القدرة المتاحة للاستعمال والمعرفة المتاحة للباحثين خارج الشركة لإعادة بنائها أو اختبار أسبابها. لا يمكن استخراج هذه التفاصيل المفقودة من نتائج الأداء وحدها.
جذبت محادثات Bing/Sydney اهتمامًا إضافيًا بسبب ردود بدت ذات طابع شخصي أو عاطفي. لكنها تبقى مخرجات نظام محادثة، وليست دليلًا على أن للنموذج رغبات أو وعيًا. والأهم عمليًا كان انتقال النماذج من إنتاج النص إلى اقتراح استخدام خدمات أخرى. قدمت OpenAI الإضافات (plugins) ثم استدعاء الوظائف (function calling)، بما يسمح للنموذج بتحديد الأداة المطلوبة وصياغة مدخلات منظمة لها. يظل البرنامج المحيط بالنموذج هو الذي يقرر تنفيذ الطلب فعليًا وحدود الصلاحيات الممنوحة له.
2023: تشغيل النموذج على جهازك يغيّر قواعد اللعبة
اتسع مسار آخر في 2023 مع LLaMA من Meta، ومشروع llama.cpp، وتجارب مثل Alpaca. أظهرت هذه الأعمال أن استخدام نموذج لغوي لم يعد مشروطًا دائمًا بالاتصال بمزود خدمة تجارية. أمكن تشغيل نماذج على أجهزة شخصية، وبناء أدوات حولها، وتجربة تعديلات محددة، وإن بقيت القيود المرتبطة بالرخص ومصادر الأوزان قائمة.
كان التكميم (Quantization) جزءًا أساسيًا من القصة. فبدل تخزين كل وزن بصيغة عددية كبيرة، يمكن تمثيل كثير من الأوزان بعدد أقل من البتات، مع موازنة أثر ذلك في الجودة. وهكذا تنخفض الذاكرة اللازمة لتشغيل بعض النماذج. وأظهر llama.cpp في مارس 2023 إمكانية تشغيل نماذج مكممة على المعالج المركزي (CPU). أما تنسيق GGUF الشائع اليوم وبعض أساليب التكميم اللاحقة فجاءت في مراحل تالية.
وتوسعت أدوات التعديل أيضًا. كانت LoRA قد ظهرت قبل هذه الموجة، ثم قدمت QLoRA طريقة لخفض متطلبات الذاكرة عند تكييف نماذج كبيرة. وفي تشغيل النماذج لخدمة عدد كبير من المستخدمين، حسّنت vLLM وتقنية PagedAttention إدارة الذاكرة المستخدمة في الاحتفاظ بنتائج الحساب السابقة أثناء توليد النص. ثم جاءت Llama 2 وMistral، وفي الصور انتشرت أدوات مثل ControlNet للتحكم بتكوين الصورة المولدة. امتلاك الأوزان يمنح المطور حرية أكبر في التجربة والتشغيل؛ لكنه لا يعني أن تدريب نموذج من الصفر أصبح في متناول الجميع.
ولمن يريد اختيار جهاز لتشغيل النماذج محليًا اليوم: سوق الحوسبة الشخصية للذكاء الاصطناعي في 2026.
أواخر 2023: البيانات والملكية والسلطة على المنصات
كلما ازدادت قيمة النصوص والصور بوصفها مادة للتدريب، اشتدت المنافسة حول حق الوصول إليها. غيّرت Reddit شروط الوصول إلى واجهتها البرمجية وأدخلت رسومًا على استخدامات معينة، وأعلنت Twitter، التي صارت X لاحقًا، تغييرات في الوصول إلى بياناتها. لكن دفع رسوم لاستخدام واجهة برمجية لا يعني تلقائيًا الحصول على ترخيص لتدريب النماذج على كل ما تعرضه، كما لا يمنع بالضرورة كل وسائل جمع البيانات الأخرى.
وفي ديسمبر 2023 رفعت صحيفة نيويورك تايمز دعوى ضد OpenAI وMicrosoft بشأن استخدام موادها. قدمت الصحيفة ادعاءاتها في الدعوى، ونشرت OpenAI ردها. وتزامن ذلك مع قضايا ومطالبات لفنانين ومؤلفين وشركات صور، واتفاقات جديدة للترخيص. انتقلت بيانات التدريب من كونها موردًا تقنيًا يجمعه الباحثون إلى موضوع نزاع تجاري وقانوني واسع.
وشهد العام أيضًا تحولات في بنية السوق. عقدت OpenAI مؤتمر المطورين DevDay وأعلنت فيه Assistants API وGPTs المخصصة، ثم مرت بأزمة مجلس الإدارة التي أعادت طرح أسئلة النفوذ داخل الشركة وصلتها بمموليها. وفي السياسات العامة ظهرت تحديثات قيود تصدير الرقائق الأمريكية والأمر التنفيذي الأمريكي بشأن الذكاء الاصطناعي. وقدمت Google عائلة Gemini الأولى مع استمرار تطوير شرائح TPU، وأطلقت Mistral AI نموذج Mixtral. لم تعد المنافسة سباقًا بين المختبرات على اختبار واحد؛ لقد امتدت إلى التوزيع والملكية والحوسبة وإدارة الشركات.
وفي الصور، دخل DALL·E 3 إلى ChatGPT في أكتوبر 2023، فأصبح بالإمكان توليد الصورة ومراجعة وصفها عبر المحادثة نفسها، بدل كتابة أوامر منفصلة لكل تجربة.
2024: النص والصورة والصوت في خدمة واحدة
اتجهت المنتجات في 2024 إلى استقبال صور وأصوات وملفات أطول، والاحتفاظ ببعض المعلومات بين جلسات الاستخدام، والتكامل مع الأدوات التي يعمل عليها الناس. شهد العام GPT Store وSora، وGemini 1.5 وClaude 3 وLlama 3، ثم GPT-4o والتفاعل الصوتي، وApple Intelligence وArtifacts. ومع كل إعلان كان هناك فرق ينبغي رصده بين عرض التقنية على المسرح وموعد إتاحتها للمستخدمين بالفعل.
أثار طول نافذة السياق اهتمامًا كبيرًا. والمقصود بها مقدار النص أو البيانات التي يستطيع النموذج استقبالها في الطلب الواحد، ويُقاس عادة بوحدات تسمى التوكنات: قد يكون التوكن كلمة قصيرة أو جزءًا من كلمة أو علامة ترقيم. نافذة أكبر تسمح بإدخال مستندات أطول، لكنها لا تضمن أن النظام سيعثر على كل تفصيلة فيها أو يربط بينها بدقة. وفي تقرير Gemini 1.5 ميز الباحثون بين استرجاع معلومة واحدة مخبأة داخل سياق طويل ومهام أصعب تتطلب استرجاع معلومات كثيرة. حجم النافذة لا يساوي جودة الفهم.
واستمرت في 2024 المنافسة خارج الخدمات المغلقة. فقدمت Meta Llama 3.1 بأحجام وصلت إلى 405 مليارات معامل، وأطلقت مجموعة Qwen Qwen2.5 بأحجام متنوعة ونماذج مخصصة للبرمجة والرياضيات. وسّعت هذه الإصدارات خيارات تشغيل الأوزان وتكييفها، من دون أن تجعل تدريب أكبر النماذج متاحًا بلا بنية حوسبة ضخمة.
وراء الواجهة، كانت المشكلات الهندسية تتعقد: كيف تُخزّن النتائج الوسيطة عندما تطول المحادثة؟ وكيف يُوزع تشغيل النموذج على شرائح متعددة؟ وكيف يمكن معالجة الكلام وإنتاجه بزمن تأخير قصير يسمح بمحادثة طبيعية؟ اتسع تطوير أنظمة Blackwell، بينما تقدمت DeepSeek في مسار آخر عبر DeepSeekMath وطريقة GRPO لتحسين التدريب بالتعزيز، ثم DeepSeek-V2 وآلية الانتباه الكامن متعدد الرؤوس (MLA) لتقليل بعض تكاليف الذاكرة. ستصبح هذه الابتكارات محورية في فهم ما حدث مع DeepSeek-R1.
وفي العام نفسه، دخل قانون الاتحاد الأوروبي للذكاء الاصطناعي حيز النفاذ في 1 أغسطس 2024، مع بدء تطبيق أحكامه على مراحل لاحقة. كان ذلك تحولًا من النقاش حول مبادئ التنظيم إلى وضع التزامات قانونية تختلف بحسب نوع النظام ومخاطره.
القسم الرابع: من إنتاج الإجابة إلى تنفيذ المهمة
2024: المزيد من الحساب للوصول إلى إجابة أفضل
لم تعد زيادة القدرة مقتصرة على تدريب نموذج أكبر ثم تشغيله بالطريقة المعتادة. في 2024 ظهر اتجاه يمنح النموذج وقتًا وحسابًا إضافيين أثناء الاستدلال، أي أثناء معالجة طلب المستخدم وإنتاج الإجابة. قدمت OpenAI عائلة o1 ضمن هذا الاتجاه، مع اختبارات تتعلق بحل مسائل تتطلب خطوات متعددة، خصوصًا في الرياضيات والبرمجة.
لكي نفهم النتائج المعلنة، يجب أن نميز بين إجراءات الاختبار. هل أجاب النموذج من محاولة واحدة؟ هل أُنتجت إجابات متعددة ثم جرى التصويت بينها؟ وهل استُخدم نظام لاختيار أفضل الإجابات بعد توليدها؟ تعرض نتائج OpenAI هذه الأوضاع على نحو منفصل. تحقيق نسبة مرتفعة عند فحص عشرات المحاولات لا يعني تحقيق النسبة نفسها عندما يطرح المستخدم سؤالًا واحدًا وينتظر أول إجابة.
اقتصاديًا، يضيف الاستدلال الطويل بندًا جديدًا إلى الكلفة. فقد يستهلك الطلب الواحد حسابًا أكثر، لكنه يختصر على المستخدم ساعات من المحاولة والعمل إذا حل المهمة بالفعل. ولا تكفي مقارنة أسعار الرسائل أو نتائج اختبار واحد لمعرفة الكلفة الحقيقية؛ المقياس الأهم هو تكلفة إتمام المهمة بنجاح، بما فيها المراجعة والتصحيح والتشغيل.
أواخر 2024: النموذج يبدأ استخدام الأدوات
انتقلت الأنظمة خطوة أخرى من كتابة الإجابات إلى تنفيذ أجزاء من المهمة. عرضت Anthropic قدرة computer use التي تسمح للنموذج بالتعامل مع واجهة الحاسوب، وطرحت MCP، بينما قدمت OpenAI إصدارات جديدة من o1 وعرضت معاينة o3، وأعلنت Google Gemini 2.0 ومشروعي Astra وMariner. تختلف هذه الأمثلة في نضجها وإتاحتها: بعضها قدرات ضمن منتج، وبعضها عروض بحثية أو مواصفات لربط الأدوات.
MCP بروتوكول يساعد التطبيقات على إتاحة البيانات والأدوات للنماذج بطريقة موحدة نسبيًا. بدل كتابة ربط خاص لكل نموذج وكل مصدر، يستطيع التطبيق استخدام صيغة مشتركة لتعريف الأدوات واستدعائها. لكن البروتوكول لا يقرر وحده ما إذا كان ينبغي تنفيذ أمر بحذف ملف أو إرسال رسالة. هذه مسؤولية نظام الصلاحيات والتحقق المحيط بالنموذج.
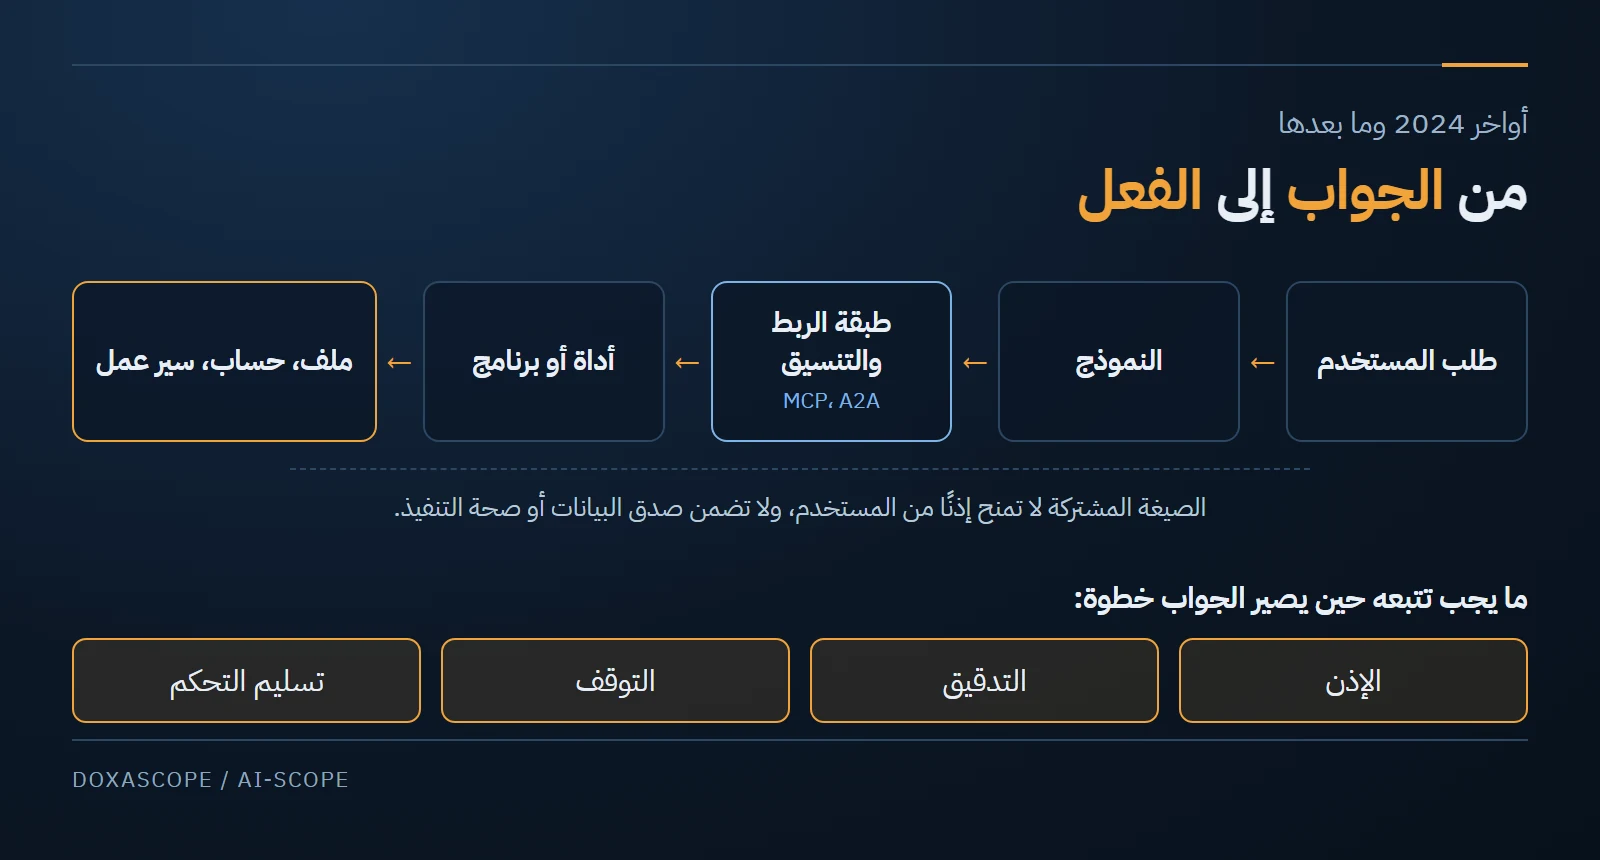
هنا يتغير نوع الخطأ. إجابة خاطئة في نافذة دردشة يمكن تجاهلها أو تصحيحها. أما إرسال رسالة إلى الشخص الخطأ، أو تعديل ملف إنتاج، أو كشف بيانات عبر أداة متصلة، فقد يترك أثرًا خارج المحادثة. لذلك أصبحت إدارة الأذونات وتسجيل الأفعال وإمكانية التراجع أو إيقاف التنفيذ شروطًا أساسية لتصميم الوكلاء، لا إضافات شكلية إلى نموذج اللغة.
DeepSeek: ماذا يعني أن يصبح التدريب أرخص؟
في أواخر 2024 نشر فريق DeepSeek تقرير V3، ثم أثار R1 في يناير 2025 اهتمامًا عالميًا بقدرات الاستدلال وكفاءة تطوير النماذج. اختلط في التغطية الإعلامية رقم تكلفة التدريب بتكلفة بناء المشروع بأكمله، مع أنهما شيئان مختلفان.
ذكر تقرير V3 استخدام نحو 2.788 مليون ساعة من معالجات H800 في التدريب المعلن، وقدر كلفتها بما يقارب 5.576 مليون دولار على أساس دولارين لكل ساعة معالجة. هذا تقدير للحوسبة في نطاق محدد من التدريب، ولا يشمل جميع الأبحاث السابقة، والتجارب غير المحتسبة، وأجور العاملين، وتكاليف شراء العتاد وتشغيل المؤسسة. لذلك لا يعني الرقم أن أي شركة تستطيع إنشاء نموذج مكافئ من الصفر بالمبلغ نفسه.
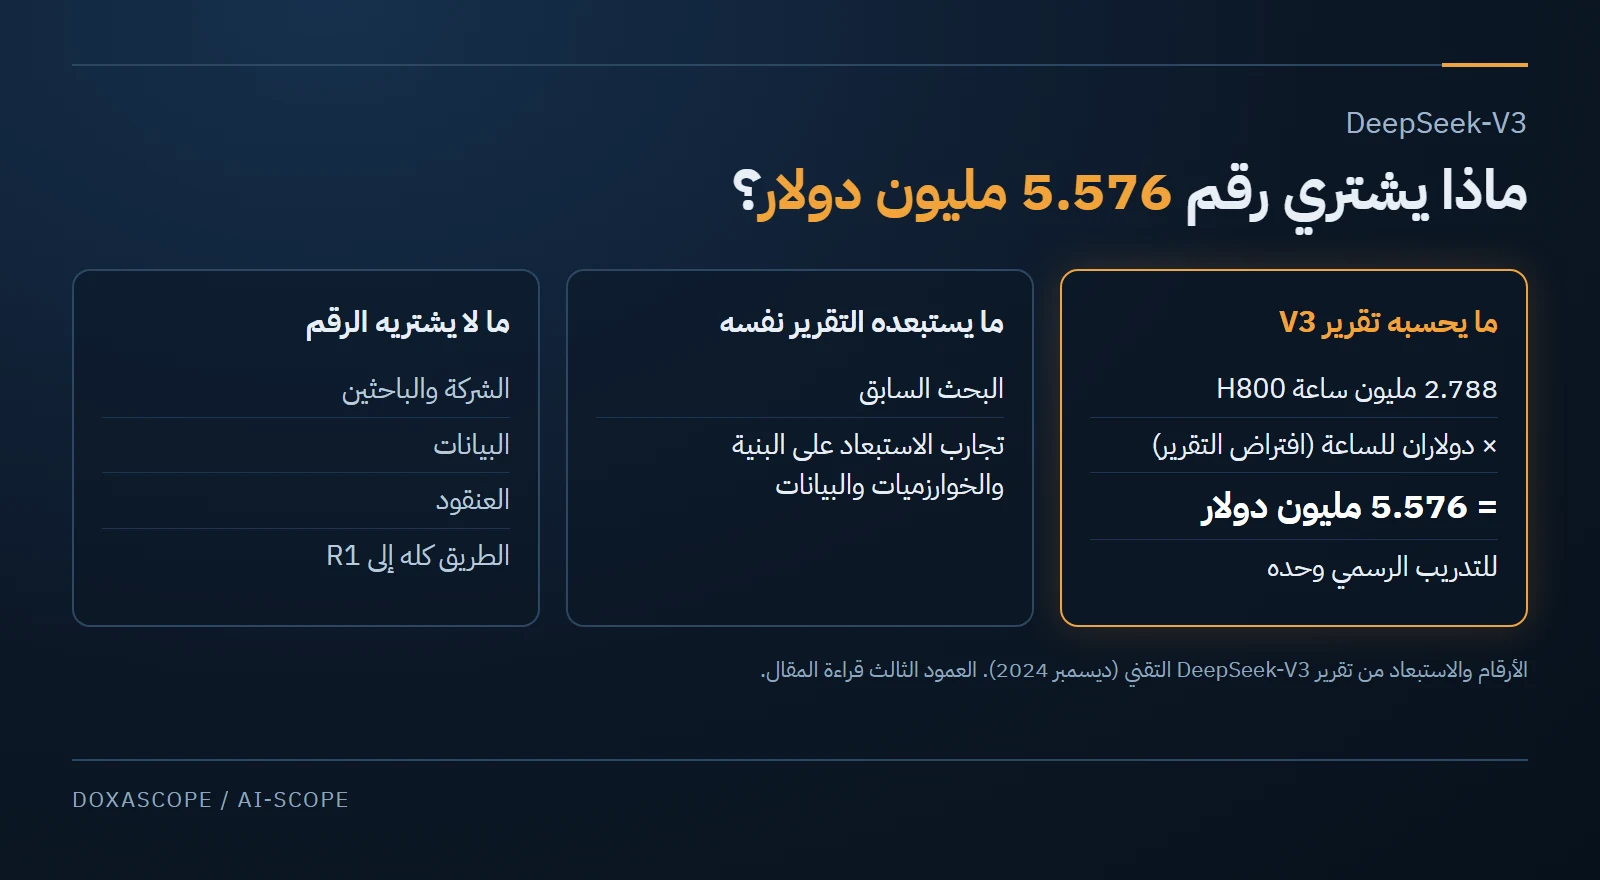
قدمت ورقة R1 كذلك صورتين مختلفتين للتدريب. استخدم R1-Zero التعلم المعزز من دون مرحلة أولية تقليدية من أمثلة الاستدلال الموجّهة، بينما اعتمد R1 النهائي على بيانات تمهيدية ومراحل إضافية لتحسين المخرجات. ولم تبدأ كل الأفكار مع R1: ظهرت GRPO سابقًا في DeepSeekMath وMLA في DeepSeek-V2. الإنجاز كان في تطوير سلسلة هندسية وبحثية متراكمة، لا في اكتشاف مفاجئ ألغى ما سبقها. وقد دُرّب V3 على معالجات H800، وهنا يعود التفريق الذي ذكرناه في قصة الرقائق: القيود سياق لهذا الابتكار، ولا دليل في التقرير على أنها سببه المباشر.
وتزامن الاهتمام بـDeepSeek مع تقلبات حادة في أسهم شركات مرتبطة بالذكاء الاصطناعي، وفي الشهر نفسه، في 21 يناير، أعلنت OpenAI وشركاؤها مشروع Stargate بخطة استثمار تصل إلى 500 مليار دولار خلال أربع سنوات. كان ذلك هدفًا استثماريًا معلنًا. وتكشف الواقعتان اتجاهين متوازيين: تحسين كفاءة النماذج من جهة، وبناء مراكز حوسبة أكبر لخدمة الطلب المتزايد من جهة أخرى. انخفاض كلفة بعض العمليات لا يعني تلقائيًا انخفاض إجمالي الإنفاق إذا توسعت الاستخدامات والحجم المطلوب.
ولمزيد عن اقتصاد البنية التحتية وكلفة مواكبة تطورها: فاتورة عدم التراجع.
2025: الوكلاء ينفذون مهام متعددة الخطوات
في 2025 تحولت بعض إمكانات الوكلاء إلى منتجات يستخدمها الناس. قدمت OpenAI Operator بوصفه تجربة لاستخدام المتصفح، ثم Deep Research للبحث عبر خطوات ومصادر متعددة. وأطلقت Anthropic Claude Code مع Claude 3.7، فيما قدمت OpenAI Responses API وAgents SDK لبناء تطبيقات تستخدم أدوات وتدير خطوات متتابعة.
لنفترض أن المستخدم طلب إصلاح خلل في موقع. كتابة سطر برمجي جديد ليست إلا جزءًا من المهمة. على النظام أن يقرأ المشروع، ويحدد مكان الخلل، ويعدل الملفات المناسبة، ويشغل الاختبارات، ثم يراجع أثر التغيير. هذه السلسلة هي ما يميز الوكيل عن النموذج الذي يكتفي باقتراح كود. ومع ذلك، فالإذن والتنفيذ الناجح مسألتان منفصلتان.
استمر تطوير نماذج الاستدلال والتخصيص، ومنها Gemini 2.5 وo3 وo4-mini. وفي أبريل قدمت Google A2A لتسهيل التواصل بين الوكلاء، بينما يخدم MCP ربط التطبيقات بالنماذج والأدوات والبيانات. الفرق مهم: أن يعرف وكيل كيف يرسل مهمة إلى وكيل آخر لا يعني أن أيًّا منهما حصل على صلاحية تنفيذها أو أن النتيجة صحيحة.
2025: أسماء النماذج تخفي أنظمة كاملة
توالت إصدارات Llama 4 وQwen3 وClaude 4 وGPT-5 وSonnet 4.5 وGPT-5.1. لكن الاسم الذي يراه المستخدم لم يعد يصف دائمًا نموذجًا واحدًا يؤدي كل العمل وحده. فقد تعمل خلف الواجهة آلية لتوجيه الطلب إلى نموذج أسرع أو إلى نموذج ينفق وقتًا أطول في الاستدلال، إلى جانب أدوات البحث والتنفيذ وقيود الاستخدام.
وصفت OpenAI GPT-5 كنظام يجمع بين الاستجابات السريعة والتفكير الأعمق والتوجيه بينهما. وبهذا أصبحت طريقة إدارة النماذج جزءًا من جودة المنتج وكلفته، إلى جانب جودة الأوزان المدربة. فقد يتلقى مستخدمان نتائج مختلفة لأن المهام والأدوات والحدود المسموح بها مختلفة، حتى لو ظهرت لهما العلامة التجارية نفسها.
وفي نوفمبر 2025 عرضت Google توليد واجهات تفاعلية عند الطلب. لم يعد الجواب دائمًا فقرة أو صورة ثابتة؛ فقد يصنع النظام رسمًا قابلًا للتفاعل، أو محاكاة بسيطة، أو واجهة مخصصة للسؤال. وفي التقييم المنشور مع البحث بقيت المواقع التي صممها خبراء بشر أكثر تفضيلًا من الواجهات المولدة. أظهر ذلك كيف بدأت الإجابات تأخذ أشكالًا تفاعلية جديدة.
وفي الوقت نفسه استمرت بدائل معمارية مثل RWKV وMamba، وواصل Grok وغيره توسيع المنافسة. كما ظهرت مشكلة بحثية مختلفة: ماذا يحدث إذا دُرّبت نماذج جديدة مرارًا على مخرجات نماذج سابقة؟ تختلف النتيجة بحسب جودة البيانات الاصطناعية ونسبتها وطريقة الاختيار؛ لذلك لا تعني أبحاث انهيار النموذج (model collapse) أن جميع البيانات المولدة عديمة الفائدة. واتسع إلى جانب الاستخدامات المشروعة توظيف التقنية في الاحتيال والتضليل وإنشاء صور غير رضائية، ما جعل السلامة جزءًا من تاريخ الانتشار نفسه.
2026: من يحدد الإتاحة وحدود الاستخدام؟
في أبريل 2026 أعلنت DeepSeek معاينة V4 مع نافذة سياق تصل إلى مليون توكن وتركيز على كفاءة التشغيل. وفي مايو عرضت Google Gemini Omni وGemini 3.5 ضمن تطوير الوسائط المتعددة والتفاعل مع الأدوات. وفي 7 أكتوبر أعلنت OpenAI توسيع إتاحة GPT-6 وIntelligent UI، بعد تقديم نماذج من العائلة في سبتمبر. كانت الواجهة التفاعلية نفسها تتحول إلى جزء من الإجابة، بدل أن تكون شاشة ثابتة لعرض النص.
لم تعد الإتاحة محكومة بالأسعار والسياسات التجارية وحدها. ففي يونيو 2026 أعلنت Anthropic أنها عطلت الوصول إلى Fable 5 وMythos 5 بعد توجيه حكومي أمريكي، ثم أعلنت في 30 يونيو رفع القيود، وإعادة إتاحة Fable 5 للمستخدمين حول العالم عبر خدماتها من 1 يوليو، ووصولًا محدودًا إلى Mythos 5 لجهات أمريكية محددة. يبين هذا الحدث أن قرارًا تنظيميًا يمكن أن يغير الوصول إلى خدمة قائمة في وقت قصير. وهو وصف لتسلسل أعلنت عنه الشركة.
وتغيرت العلاقة بين شركات التطوير ومقدمي البنية التحتية أيضًا. ففي 27 أبريل 2026 أعلنت OpenAI تعديلًا في اتفاقها مع Microsoft يجعل ترخيص Microsoft لتقنيات OpenAI غير حصري، مع استمرار Microsoft شريكًا أساسيًا في الحوسبة السحابية وفق الاتفاق. وهكذا لا يحدد مستقبل النماذج البحث وحده؛ بل تحدده عقود الترخيص، والقدرة على شراء الشرائح، وتوافر الطاقة، وشروط تشغيل الخدمة في أسواق مختلفة.
ظهرت خلال سبتمبر درجات متعددة من عائلة GPT-6، من Astra إلى Sol وLuna ثم GPT-6.1 Sol. أصبحت المفاضلة بين السرعة والقدرة وكلفة التشغيل جزءًا ظاهرًا من تصميم المنتجات. وبرغم التحسن في كفاءة النماذج، ما زال بناء الأنظمة الأكبر يتطلب مراكز بيانات وشبكات وتبريدًا وطاقة وفرقًا متخصصة. لا يختفي هذا العالم المادي عندما تصبح واجهة الاستخدام أبسط.
ما الذي أصبح في متناولنا؟
بدأت الرحلة الحديثة بتحسين طريقة حساب العلاقات بين الكلمات، ثم اتسعت إلى نماذج تتعلم من نصوص وصور وأصوات، وتسترجع معلومات، وتكتب برامج، وتستخدم أدوات، وتبني واجهات تفاعلية. أصبح الوصول إلى هذه القدرات أسهل وأقل كلفة في كثير من الاستخدامات، وأتاحت النماذج ذات الأوزان المنشورة مسارات جديدة للعمل المستقل. لكن تدريب النماذج الأكثر تطورًا وتشغيلها على نطاق هائل ما زال يحتاج إلى رأسمال وعتاد وبيانات وخبرات لا تتوزع بالتساوي.
هنا تتضح المفارقة المركزية في الصناعة: اتسعت دائرة من يستطيعون استخدام الذكاء الاصطناعي، بينما ظلت القدرة على بناء أنظمته الكبرى وتحديد شروط الوصول إليها متركزة لدى عدد محدود من الشركات والمؤسسات. فتح نشر الأوزان بابًا مهمًا خارج الخدمات المغلقة، لكنه لم يلغِ الفارق بين تشغيل نموذج موجود وتطوير نموذج حدودي من الصفر.
ولذلك لا يكفي سؤال «ما النموذج الأفضل؟» لفهم المرحلة. علينا أن نسأل أيضًا: ما المهام التي ينجزها بالفعل؟ وما كلفة إنجازها بعد المراجعة والتصحيح؟ من وفر بيانات التدريب؟ من قام بالعمل البشري وراء النتائج؟ من يملك صلاحية تنفيذ الأفعال؟ وهل يستطيع المستخدم فحص النظام أو استبداله أو تشغيل بديل عنه؟
هذه الأسئلة تربط تاريخ الخوارزميات بتاريخ الاقتصاد والمؤسسات وحقوق الأفراد. فمن 2017 إلى أكتوبر 2026 لم تتقدم الآلات وحدها؛ تغيرت أيضًا الطريقة التي تُبنى بها المعرفة الرقمية، وتباع بها القدرة الحسابية، وتتوزع بها السلطة على ما يستطيع المستخدم فعله. وهذا هو عصر الذكاء الاصطناعي كما تكوّن: إنجاز علمي كبير، وصناعة كثيفة الموارد، وأدوات ينتشر استخدامها أسرع من انتشار القدرة على صنعها.