سوق الحوسبة الشخصية للذكاء الاصطناعي في 2026
2026-09-24 · A.F. Sadek
اختر القيد الذي تريد إزالته أولًا: مقارنة عملية بين مسار البطاقات المنفصلة ومسار الذاكرة الموحدة
تفضّل القراءة بالإنجليزية؟ اقرأ النسخة الإنجليزية.
تحديث: 24 سبتمبر 2026
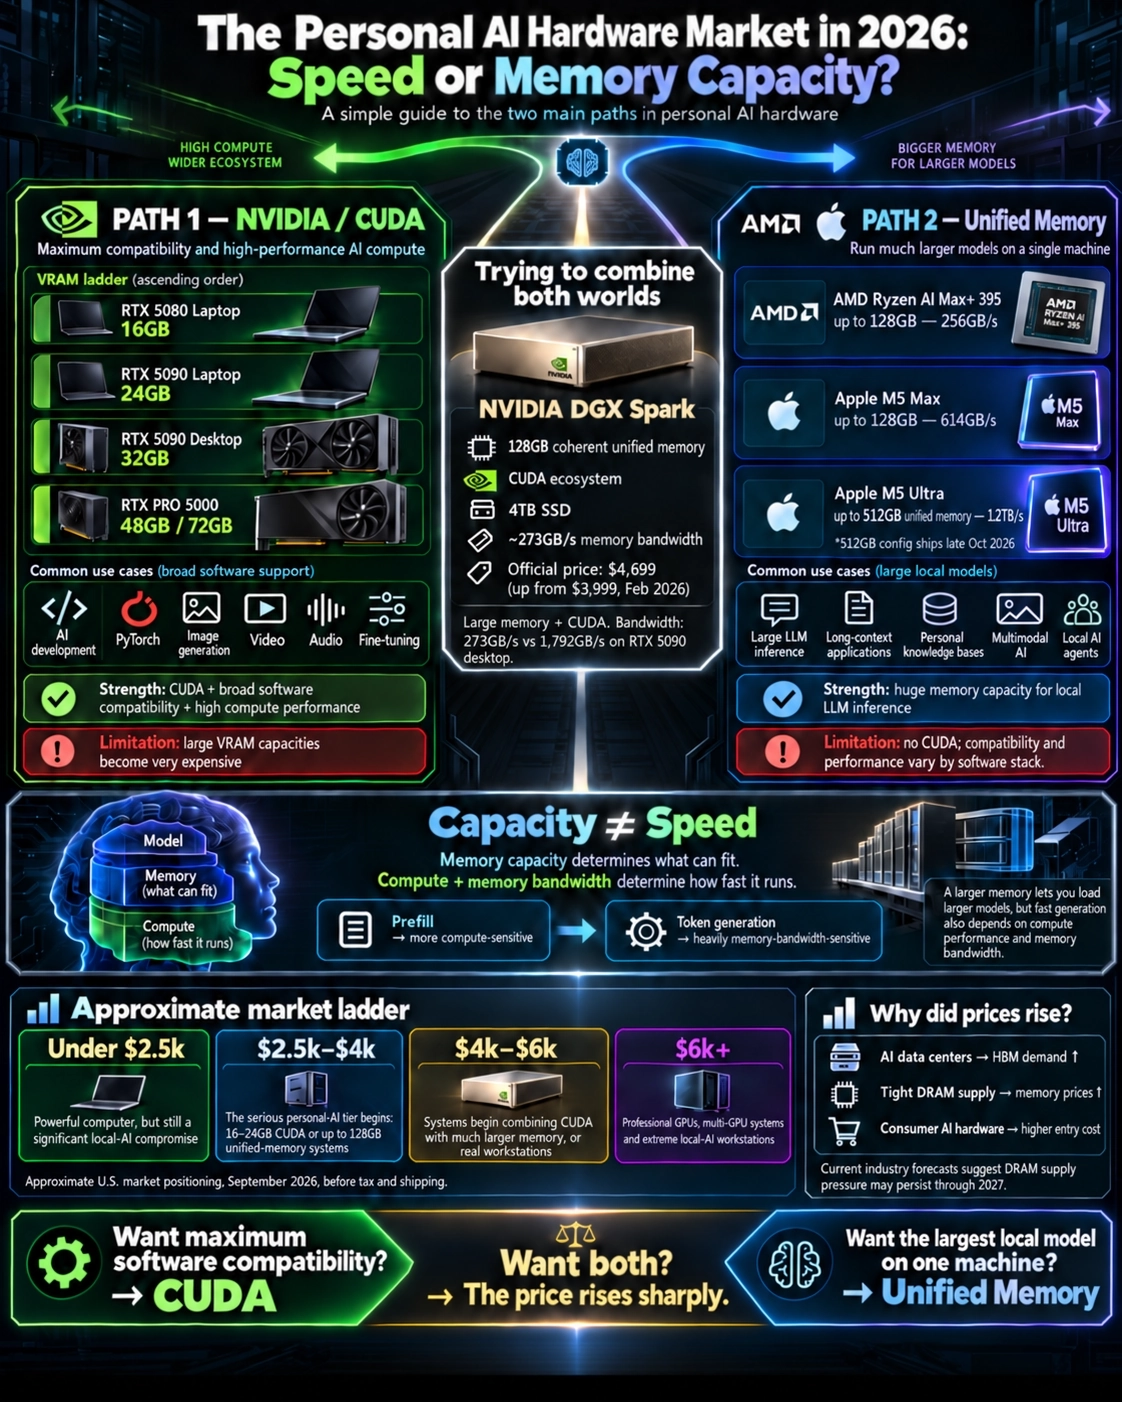
خلال عامين فقط تغيّر معنى «جهاز قوي للذكاء الاصطناعي». حتى وقت قريب، كانت ميزانية في حدود 2,500 دولار تضعك بوضوح في الفئة العليا من الحوسبة الاستهلاكية. اليوم ما زال المبلغ نفسه يشتري جهازًا شديد القوة، لكنه يضعك أمام اختيار: سرعة GPU عالية وتوافق واسع مع أدوات الذكاء الاصطناعي، أو ذاكرة كبيرة تكفي لتشغيل نماذج ضخمة محليًا. أما الجمع بينهما في جهاز واحد فصار يحتاج ميزانية أكبر بكثير.
والسبب مزدوج: السوق أصبح أغلى، وأحمال الذكاء الاصطناعي نفسها انقسمت إلى احتياجات مختلفة.
عمليًا، السوق الشخصي اليوم يتحرك على مسارين رئيسيين:
- بطاقة GPU منفصلة، وCUDA هي المنظومة المهيمنة: تقدم أفضل توافق برمجي وأداء مرتفع في طيف واسع من مهام الذكاء الاصطناعي، لكن الوصول إلى VRAM كبيرة أصبح مكلفًا بسرعة. وخارج NVIDIA ظهرت بدائل أرخص بمنظومة برمجية أضيق.
- الذاكرة الموحدة (Unified Memory): ذاكرة مشتركة ضخمة تسمح بتشغيل نماذج أكبر محليًا، لكن غالبًا من دون CUDA، وبأداء وتوافق يختلفان حسب البرنامج.
وبينهما توجد فئة صغيرة تحاول الجمع بين العالمين، مثل NVIDIA DGX Spark أو بطاقات RTX PRO بذاكرة من 48 إلى 72GB، لكن السعر ينتقل سريعًا إلى مستوى محطات العمل (Workstations).
لذلك صار السؤال المفيد في 2026:
ما هو القيد الذي تريد إزالته أولًا؟
المقارنة الأساسية بين المنصات
- RTX 5080 Laptop: ذاكرة 16GB GDDR7 • عرض نطاق 896GB/s • دعم CUDA: نعم
← الاستخدام الأنسب: أدوات الذكاء الاصطناعي العامة في جهاز محمول. - RTX 5090 Laptop: ذاكرة 24GB GDDR7 • عرض نطاق 896GB/s • دعم CUDA: نعم
← الاستخدام الأنسب: أحمال CUDA أكبر ومشاريع متقدمة في لابتوب. - RTX 5090 Desktop: ذاكرة 32GB GDDR7 • عرض نطاق 1,792GB/s • دعم CUDA: نعم
← الاستخدام الأنسب: أعلى أداء حسابي وسرعة معالجة محلية. - RTX PRO 5000 Blackwell: ذاكرة 48GB / 72GB GDDR7 ECC • عرض نطاق 1,344GB/s • دعم CUDA: نعم
← الاستخدام الأنسب: أحمال CUDA الاحترافية ومحطات العمل الثقيلة. - Ryzen AI Max+ 395: حتى 128GB LPDDR5X مشتركة • عرض نطاق نحو 256GB/s (نظريًا) • دعم CUDA: لا
← الاستخدام الأنسب: تشغيل نماذج كبيرة محليًا على Windows / Linux. - Apple M5 Max: حتى 128GB Unified • عرض نطاق حتى 614GB/s • دعم CUDA: لا
← الاستخدام الأنسب: نماذج محلية كبيرة، وأحمال MLX / Metal. - Apple M5 Ultra: حتى 512GB Unified • عرض نطاق 1.2TB/s • دعم CUDA: لا
← الاستخدام الأنسب: تشغيل أضخم النماذج محليًا على جهاز مكتبي. - NVIDIA DGX Spark: ذاكرة 128GB Coherent Unified • عرض نطاق 273GB/s • دعم CUDA: نعم
← الاستخدام الأنسب: تطوير ونماذج كبيرة ضمن بيئة CUDA المتكاملة.
ملاحظة: استبعدنا الأسعار المباشرة والتوفر اللحظي من هذه المقارنة لأنها تتحرك أسرع بكثير من المواصفات الهندسية الثابتة، ونفصل النطاقات السعرية لاحقًا في المقال.
لماذا أصبحت الذاكرة أهم من أي وقت مضى؟
في الاستخدام التقليدي كان تقييم الكمبيوتر يبدأ غالبًا من المعالج المركزي (CPU)، ثم المعالج الرسومي (GPU)، ثم ذاكرة النظام (RAM).
أما في الذكاء الاصطناعي المحلي، فقد صار السؤال الأول في حالات كثيرة:
هل النموذج أو سير العمل (workflow) يدخل في ذاكرة الـGPU أصلًا؟
إذا لم يدخل، تصبح السرعة النظرية مسألة ثانوية، ويبقى أمامك: تقسيم الحمل على أكثر من GPU، أو نقل جزء منه إلى RAM أبطأ، أو تقليل الدقة (Quantization)، أو اللجوء إلى السحابة.
لذلك توجد فروق نوعية بين طبقات الذاكرة:
- من 8 إلى 12GB: مناسبة لأحمال صغيرة ومتوسطة، لكنها أصبحت ضيقة بسرعة في الأعمال الحديثة.
- 16GB: قوية للاستخدام العام، لكنها تصطدم بالنماذج وسير العمل الكبير.
- 24GB: بداية مساحة جدية للعمل المحلي المتقدم.
- 32GB: أوسع بوضوح، وما زالت ضيقة على النماذج الضخمة.
- من 48 إلى 72GB: تبدأ منطقة محطات العمل (Workstation) الحقيقية لـCUDA والنماذج الأكبر.
- 128GB وما فوق: تفتح فئة مختلفة تمامًا من التشغيل والاستدلال المحلي (Local Inference).
الجيل المحمول الحالي يوضح المشكلة جيدًا؛ فبحسب المواصفات الرسمية لبطاقات NVIDIA RTX 50 المحمولة، تحمل RTX 5080 Laptop ذاكرة 16GB GDDR7، بينما تحمل RTX 5090 Laptop ذاكرة 24GB، وكلاهما يصل إلى 896GB/s من عرض النطاق. لذلك جزء كبير من قيمة 5090 في أعمال الذكاء الاصطناعي يأتي من زيادة السعة نفسها، وليس فقط من قوة الحساب.
أما في جدول مقارنة بطاقات المكتب من NVIDIA، فيقفز RTX 5090 المكتبي إلى 32GB GDDR7، و21,760 CUDA core، وعرض نطاق 1,792GB/s. الاسم متشابه، لكن بطاقة المكتب تحمل ذاكرة أكبر بالثلث وضعف عرض النطاق مقارنة بنسخة اللابتوب.
المسار الأول: GPU منفصل، وCUDA هي المنظومة المهيمنة
هذا هو الطريق الأبسط لمن يريد جهازًا للذكاء الاصطناعي يعمل مع كل شيء تقريبًا.
ميزة CUDA الكبرى هي منظومتها البرمجية: عدد كبير من أدوات البحث والتطوير، وإضافات PyTorch، وTriton kernels، وDiffusers، وأدوات توليد الفيديو والصوت، وأدوات الضبط الدقيق (fine-tuning) تظهر أولًا أو تعمل بأفضل صورة على NVIDIA.
هذا يجعل NVIDIA غالبًا المسار الأقل احتكاكًا برمجيًا؛ أي أن أغلب المشاريع والمستودعات البرمجية تعمل فورًا دون تعديل يُذكر.
المشكلة أن VRAM الكبيرة أصبحت الجزء الأغلى في المعادلة كلها.
1. الحواسيب المحمولة (Laptops)
في أعلى السوق المحمول الحالي:
- RTX 5080 Laptop — 16GB
- RTX 5090 Laptop — 24GB
هذه المعالجات الرسومية قوية جدًا، لكن ذاكرتها غير قابلة للترقية، والطاقة والتبريد محدودان بجسم اللابتوب. لذلك يستحق أعلى Laptop GPU حسابًا دقيقًا للقيمة مقابل التكلفة قبل الشراء.
2. الحواسيب المكتبية (Desktops)
بطاقة RTX 5090 Desktop تقدم:
- ذاكرة 32GB GDDR7
- عرض نطاق 1,792GB/s
- 21,760 نواة CUDA
وتوفر مساحة أكبر للتبريد، وذاكرة نظام أكبر، وسعات تخزين أوسع، مع إمكانية ترقية واستبدال البطاقة لاحقًا.
ومع ذلك، تبقى 32GB ضيقة أمام النماذج اللغوية الضخمة (مثل عائلة 70B مع سياق طويل).
3. الفئة الاحترافية (Workstations)
تأتي بطاقة NVIDIA RTX PRO 5000 Blackwell بخيارين:
- 48GB GDDR7 ECC
- 72GB GDDR7 ECC
- 1,344GB/s
- 300W
هنا تبدأ NVIDIA في تقديم سعة VRAM مناسبة فعلًا لمحطات الذكاء الاصطناعي المهنية، لكن السعر يقفز مباشرة إلى فئة محطات العمل المرتفعة.
الأسعار الفعلية لهذه الفئة شديدة التذبذب، وتختلف كثيرًا بين النسخ والعلامات التجارية حتى داخل متجر NVIDIA Marketplace نفسه. الثابت أن الانتقال إلى ذاكرة CUDA من 48 إلى 72GB يضع المشتري سريعًا في فئة تسعير احترافية باهظة.
4. ذاكرة VRAM منفصلة خارج NVIDIA
ظهرت بدائل جديدة تخفّض تكلفة الذاكرة المنفصلة، مقابل منظومة برمجية أضيق:
- AMD Radeon AI PRO R9700: 32GB GDDR6، و640GB/s، و300W، وسعر رسمي (MSRP) يبلغ 1,299 دولار، والأسعار الفعلية أعلى منه ومتقلبة. تقدمه AMD كبطاقة لمحطات عمل الذكاء الاصطناعي، ويعتمد على ROCm مكان CUDA.
- Intel Arc Pro B60: 24GB GDDR6، و456GB/s، ودعم multi-GPU على Linux. قيمته الأساسية سعة VRAM كبيرة بسعر أقل، مع منظومة برمجية أصغر من CUDA.
الخلاصة: الذاكرة المنفصلة الكبيرة صارت متاحة خارج NVIDIA، والسعر الأقل يشتري سعة VRAM أكبر، بينما يبقى التوافق البرمجي أضيق.
Multi-GPU: توسعة داخل مسار البطاقات المنفصلة
يمكن استخدام بطاقتين أو أكثر لتوزيع نموذج كبير بينهما.
على سبيل المثال، بطاقتان كل منهما 24GB توفران 48GB من الذاكرة الفعلية المتاحة للعمل الموزع.
لكنهما تبقيان بطاقتين منفصلتين: البرنامج نفسه يجب أن يدعم تجزئة النموذج (model sharding) أو التوازي على مستوى الطبقات (tensor/layer parallelism)، كما تؤثر سرعة مسارات PCIe وطريقة توزيع الحمل في الأداء الإجمالي.
تعدد البطاقات (Multi-GPU) يمكن أن يكون طريقًا قويًا، خصوصًا مع محطات عمل مستعملة أو منصات Threadripper/EPYC، لكنه يأتي بتكاليف واضحة:
- صندوق أكبر
- مزود طاقة (PSU) أقوى
- حرارة وضوضاء
- استهلاك كهرباء أعلى
- تعقيد برمجي وهندسي في الإعداد
لذلك هو مسار توسعة حقيقي وفعّال، لكن له كلفته التشغيلية الخاصة.
المسار الثاني: الذاكرة الموحدة (Unified Memory)
هنا تتغير المعادلة تمامًا.
بدل تزويد الـGPU بذاكرة منفصلة صغيرة وفائقة السرعة، يستطيع المعالج المركزي (CPU) والمعالج الرسومي (GPU) الوصول إلى مساحة ذاكرة مشتركة وضخمة.
الميزة الأساسية هنا هي السعة: تصبح الذاكرة المتاحة للـGPU أكبر بكثير، بينما يختلف عرض نطاقها حسب المنصة، وغالبًا ما يبقى أقل من أسرع VRAM منفصلة في بطاقات الديسكتوب العليا.
1. معالجات Apple Silicon
يقدم جهاز Apple Mac Studio لعام 2026 خيارين رئيسيين:
M5 Max
- حتى 128GB unified memory
- حتى 614GB/s memory bandwidth
M5 Ultra
- حتى 512GB unified memory
- 1.2TB/s memory bandwidth
يبدأ Mac Studio M5 Max رسميًا من 2,499 دولار، بينما يبدأ M5 Ultra من 5,499 دولار.
وبحسب بيان الإعلان الرسمي من Apple، بدأت الأجهزة الجديدة في الوصول للعملاء في 22 سبتمبر 2026، بينما تكوين 512GB unified memory على M5 Ultra مقرر أن يبدأ شحنه في أواخر أكتوبر 2026.
2. منصة AMD Strix Halo
يقدم معالج AMD Ryzen AI Max+ 395 الفكرة نفسها لكن على بيئة Windows وLinux:
- معالج بـ16 نواة و32 مسار تنفيذ (threads)
- Radeon 8060S
- حتى 128GB LPDDR5X-8000
- ناقل ذاكرة بعرض 256 بت، أي نحو 256GB/s نظريًا
وتوجد بالفعل أجهزة مصغرة مبنية حول هذا المعالج؛ مثل جهاز Minisforum MS-S1 Max بذاكرة 128GB RAM + 2TB SSD الذي كان معروضًا مباشرة على موقع الشركة بسعر 2,919.90 دولار وقت المراجعة، مع الإشارة إلى نفاد الكمية (Sold out).
وهذا يجسد طبيعة السوق: أجهزة Strix Halo تتأثر سريعًا بتقلبات أسعار الذاكرة والمخزون، لذلك يجدر التعامل معها كنطاق سوقي متحرك.
Unified Memory: سعة كبيرة بشروط
جهاز يحمل 128GB من الذاكرة الموحدة وبطاقة NVIDIA بذاكرة 128GB شيئان مختلفان تمامًا في الأداء والوظيفة.
تحدد التجربة ثلاثة عناصر مستقلة:
- السعة (Capacity): ما النماذج التي يمكن تحميلها واستيعابها في الذاكرة؟
- الحساب (Compute): كم يستطيع المعالج الرسومي حسابه ومعالجته في الثانية؟
- المنظومة البرمجية (Software Stack): هل البرنامج أو النموذج الذي تحتاجه مدعوم جيدًا على هذه المنصة؟
لذلك قد يتمكن جهاز بذاكرة موحدة ضخمة من تحميل نموذج لا تتسع له بطاقة RTX 5090، لكنه قد يكون أبطأ بوضوح في مراحل معينة من المعالجة.
Prefill مقابل Generation: لماذا تختلف السرعة عن السعة؟
عند استخدام النماذج اللغوية الكبيرة (LLMs) تمر المعالجة بمرحلتين متباينتين تقنيًا:
1. مرحلة قراءة السياق (Prefill / Prompt Processing)
يقرأ الجهاز المدخلات والسياق بالكامل، ويجهز الحالة الداخلية للنموذج.
هذه المرحلة تعتمد أساسًا على قوة الحساب (Compute Throughput)، خصوصًا مع السياق الطويل والوكلاء (Agents) وأنظمة استرجاع المعلومات (RAG).
2. مرحلة التوليد (Generation / Decode)
بعد معالجة السياق، يبدأ النموذج في توليد التوكنز واحدًا تلو الآخر.
هذه المرحلة شديدة الحساسية في العادة لـعرض نطاق الذاكرة (Memory Bandwidth)، لأن أوزان النموذج تُقرأ من الذاكرة مع كل توكن جديد.
لذلك فإن المعادلة التقريبية:
عرض نطاق الذاكرة (Bandwidth) ÷ حجم النموذج (Model Size)
قد تعطي تصورًا أوليًا للسقف النظري لسرعة التوليد (decode tokens/s). لكن الأداء الواقعي يخضع لعوامل إضافية، مثل: نوع التكميم (Quantization)، وحجم ذاكرة الـKV cache، وطول السياق، وكفاءة الـkernels، وبنية النموذج نفسه (نماذج MoE مقابل النماذج الكثيفة).
الخلاصة الأساسية:
السعة (Capacity) تحدد ما الذي يمكن تشغيله واستيعابه.
قوة الحساب وعرض النطاق (Compute + Bandwidth) تحددان سرعة تشغيله.
ولهذا تضلل مقولة «ذاكرة أكثر = أداء أسرع»: الذاكرة الأكبر توسّع ما يمكن تشغيله، أما السرعة فتأتي من قوة الحساب وعرض النطاق.
البعد الثالث: منظومة البرمجيات (Software Stack)
إلى جانب الحساب والذاكرة، يأتي التوافق البرمجي، وهو كثيرًا ما يحسم الاختيار:
NVIDIA
المسار الطبيعي والأكثر استقرارًا لـ:
- CUDA
- PyTorch CUDA extensions
- Triton
- FlashAttention
- Diffusers
- أغلب أدوات الضبط الدقيق (fine-tuning) وتوليد الصور والفيديو
Apple
المسار الطبيعي لـ:
- مكتبة MLX
- واجهات Metal / MPS
- llama.cpp
- التطبيقات المصممة والمحسنة خصيصًا لبيئة macOS وApple Silicon
AMD
تعتمد على:
- منظومة ROCm
- واجهات Vulkan
- llama.cpp
- الدعم الأصلي من التطبيقات المعنية
أجهزة Apple وAMD تعمل جيدًا مع أدواتها المدعومة. لكن الفارق الجوهري يظهر فور نزول مستودع بحثي جديد على GitHub يعتمد على CUDA وTriton: سيعمل فورًا على NVIDIA، بينما يتطلب تشغيله على المنصات الأخرى واجهات بديلة، أو إعادة كتابة، أو انتظار تحديثات مجتمعية.
DGX Spark: محاولة الجمع بين العالمين
يمثل جهاز NVIDIA DGX Spark واحدة من أوضح محاولات 2026 للجمع بين سعة الذاكرة الكبيرة ومنظومة CUDA المتكاملة في قالب مكتبي مدمج:
- معالج NVIDIA GB10 Grace Blackwell
- 128GB coherent unified system memory
- 273GB/s memory bandwidth
- منظومة CUDA وNVIDIA AI البرمجية الكاملة
- وحدة تخزين 4TB NVMe
- وزن نحو 1.2kg
- TDP للمعالج GB10 يبلغ 140W
تحدد NVIDIA هذا الجهاز لتطوير وتشغيل نماذج يصل حجمها إلى 200 مليار معامل (parameter)، مع إمكانية إجراء fine-tuning لنماذج تصل إلى 70 مليار معامل ضمن سيناريوهات محددة.
السعر الرسمي المعلن في الولايات المتحدة هو 4,699 دولار، بعد أن أعلنت NVIDIA في منتدى المطورين بتاريخ 23 فبراير 2026 زيادة سعره من 3,999 دولار عازية ذلك صراحة إلى قيود توريد الذاكرة عالميًا. وكان معروضًا في متجر NVIDIA Marketplace كـ Out of Stock وقت المراجعة.
الفارق بين DGX Spark وبطاقة RTX 5090 المكتبية واضح ومباشر:
- عرض نطاق ذاكرة DGX Spark يبلغ 273GB/s، مقابل 1,792GB/s في RTX 5090 المكتبي.
- تصميمه مخصص لتطوير الذكاء الاصطناعي والاستدلال بهدوء وكفاءة في قالب صغير وموفر للطاقة.
- أما الأحمال التي تتطلب أقصى سرعة حسابية وأعلى عرض نطاق، فمكانها البطاقات المكتبية عالية الاستهلاك.
ما الذي قد يغيّر الصورة خلال أسابيع؟ RTX Spark
هناك تطور مرتقب يصل إلى الأسواق في أكتوبر: NVIDIA RTX Spark.
أعلنت NVIDIA عبر بيانها الصحفي المشترك مع مايكروسوفت أن منصة RTX Spark ستصل إلى الحواسيب المحمولة العاملة بنظام Windows وأجهزة سطح المكتب المصغرة، بمواصفات تشمل:
- معالج رسومي Blackwell RTX بما يصل إلى 6,144 نواة CUDA
- معالج مركزي Grace CPU مكوّن من 20 نواة
- ذاكرة موحدة تصل إلى 128GB unified memory
- دعم كامل لمنظومة برمجيات CUDA وRTX
- نظام Windows على معالجات Arm
وفي سبتمبر، أكدت NVIDIA عبر مدونتها الرسمية في معرض IFA أن أولى هذه الأجهزة ستبدأ بالوصول في أكتوبر 2026.
وأهميته أنه ينقل معادلة DGX Spark إلى حواسيب Windows الشخصية: ذاكرة موحدة واسعة + دعم CUDA كامل + جهاز يومي متكامل.
لكن الأسعار الرسمية، والأداء المستمر تحت الضغط، وعرض نطاق الذاكرة ما زالت غير معلنة. ولأن المعالج يعتمد بنية Arm، توضح وثائق Microsoft Learn أن نظام Windows 11 قادر على تشغيل برمجيات x86/x64 عبر محاكي Prism، إلا أن التعريفات ومكونات النواة (Kernel drivers) تتطلب دعمًا أصليًا لبنية Arm64، لذلك يُحسم التوافق الفعلي بالتجربة بعد الإطلاق.
لهذا السبب يبقى RTX Spark خارج جدول الأسعار الحالي، ويمثل الفئة الأبرز للمتابعة في الفترة القادمة.
وماذا عن Huawei؟
أصبحت شرائح Ascend منافسًا جديًا في بنية الذكاء الاصطناعي التحتية، مع أجيال جديدة مخطط لها في 2027 وما بعدها. لكنها حتى الآن خارطة طريق لمراكز البيانات، ولم يُعلن بعدُ جهاز شخصي منها بمواصفات وسعر وتوفر عالمي. وتقول Huawei نفسها إن الطلب داخل الصين يتجاوز قدرتها الإنتاجية، وإن هذا يحدّ من توسعها الخارجي.
لماذا ارتفعت الأسعار بهذه الصورة؟
يعود هذا الارتفاع الحاد في أسعار أجهزة الذكاء الاصطناعي إلى أزمة في المنبع: صناعة الذاكرة نفسها.
تتوقع شركة الأبحاث TrendForce في تقريرها لسوق الذاكرة استمرار ضيق المعروض في سوق DRAM طوال عام 2027، نتيجة استمرار تحويل خطوط الإنتاج نحو ذاكرة النطاق العريض (HBM) وذاكرة الخوادم ومراكز البيانات لتلبية الطلب الهائل على البنية التحتية للذكاء الاصطناعي. وفي المقابل، تتوقع تحسنًا ملحوظًا في توازن سوق ذاكرة فلاش NAND بدءًا من النصف الثاني من 2027.
والدليل الأوضح جاء من NVIDIA نفسها: رفعت سعر DGX Spark من 3,999 إلى 4,699 دولار، وأرجعت الزيادة صراحة إلى قيود توريد الذاكرة.
كما قدمت شركة Framework مثالًا واقعيًا من الشركات الصغرى؛ إذ أوضحت في تحديثها لأسعار الذاكرة في 15 يونيو 2026 أن تكلفة ذاكرة LPDDR5X واصلت الارتفاع، فاضطرت إلى رفع سعر تكوين 128GB من Framework Desktop مع استهلاك مخزونها وشراء ذاكرة جديدة بأسعار أعلى.
المحصلة أن ارتفاع الأسعار يمتد من الشركات الكبرى مثل Apple وNVIDIA إلى صغار المصنّعين: الذاكرة عالية السعة صارت موردًا شحيحًا يتنافس عليه الجميع.
وماذا عن الـNPU وشعار «AI PC»؟
وحدات المعالجة العصبية (NPU) ممتازة في المهام المحلية منخفضة استهلاك الطاقة، مثل المزايا المدمجة في نظام التشغيل، ومعالجة مؤثرات الكاميرا والميكروفون، وبعض مهام الاستدلال السريعة في الخلفية. وهي تتطور بسرعة: وحدة NPU في Snapdragon X2 Elite من Qualcomm تصل إلى 80 TOPS، وتستهدف الوكلاء المحليين والكفاءة في استهلاك الطاقة.
أما في الأحمال الثقيلة، فيتراجع دورها كثيرًا، ومنها:
- تشغيل النماذج اللغوية الكبيرة (LLMs) محليًا
- توليد الصور (Image Generation)
- توليد الفيديو
- الضبط الدقيق للنماذج (Fine-tuning)
- أحمال البحث والبرمجة المعتمدة على PyTorch وCUDA
في هذه الاستخدامات، المواصفات الحاسمة هي:
سعة VRAM أو الذاكرة الموحدة (Memory Capacity)
قوة المعالجة الرسومية (GPU Compute)
عرض نطاق الذاكرة (Memory Bandwidth)
التوافق البرمجي (Software Ecosystem)
منظومة التبريد وإمداد الطاقة (Cooling and Power)
نطاق هذا المقال
يركز هذا التحليل على بنية السوق المتاحة للمشتري العام في سبتمبر 2026، ويترك خارجه حصر السوق المستعمل وكل بطاقة متخصصة. السوق المستعمل، مثل بطاقات RTX 3090 ومحطات العمل القديمة، قد يقدم قيمة ممتازة، ولا سيما عند تجميع منصات multi-GPU، لكن أسعاره شديدة التقلب. لذلك تناولنا multi-GPU كمسار معماري وتوسعي.
ثلاثة أشكال للأجهزة، ومساران تقنيان
يقدم السوق اليوم ثلاثة أشكال رئيسية للأجهزة:
1. الحاسوب المحمول (Laptop)
يجمع النظام كله في جهاز قابل للحمل، لكن الـGPU وذاكرته غير قابلين للترقية، والذاكرة الرئيسية كذلك في أغلب الأجهزة، والأداء محكوم بحدود الطاقة والتبريد.
2. الحاسوب المكتبي ومحطات العمل (Desktop / Workstation)
أكبر حجمًا وأعلى استهلاكًا للطاقة، لكنه يقدم أقصى درجات الأداء، وأفضل منظومات التبريد، وقابلية كاملة للترقية وإضافة بطاقات متعددة.
3. الصناديق المصغرة (Mini AI Box)
أجهزة مدمجة للغاية مثل DGX Spark أو منصات Ryzen AI Max؛ يمكن توصيلها بالشبكة واستخدامها كخادم ذكاء اصطناعي شخصي يُدار عن بُعد من جهازك اليومي.
وتحت هذه الأشكال الثلاثة تظل المعادلة الحاكمة ثابتة:
بطاقة منفصلة من NVIDIA ← توافق كامل مع CUDA وسرعة فائقة.
ذاكرة موحدة ضخمة (Unified Memory) ← إمكانية تشغيل نماذج أكبر محليًا.
الجمع بين الميزتين ← انتقال سريع إلى أسعار محطات العمل الاحترافية.
خريطة السوق التقريبية بالدولار
الأسعار أدناه نطاقات تقريبية لسوق الولايات المتحدة لشهر سبتمبر 2026 (قبل الضرائب وتكاليف الشحن):
أقل من 2,500 دولار:
ماذا يمنحك: حاسوب قوي جدًا للأعمال العامة أو نظام ذكاء اصطناعي متوسط.
التنازل المعتاد: تنازل ملموس في سعة VRAM أو حصر العمل في نماذج صغيرة ومتوسطة.من 2,500 إلى 4,000 دولار:
ماذا يمنحك: منصة جادة للعمل المحلي: بطاقة CUDA بذاكرة من 16 إلى 24GB، أو نظام Unified Memory بسعة 128GB.
التنازل المعتاد: التضحية إما بسرعة المعالجة وعرض النطاق أو بالتوافق البرمجي لبيئة CUDA.من 4,000 إلى 6,000 دولار:
ماذا يمنحك: أنظمة تجمع بين CUDA والذاكرة الكبيرة (DGX Spark) أو محطات عمل حقيقية.
التنازل المعتاد: تكلفة مرتفعة وقفزة حادة في ميزانية الاستثمار.6,000 دولار فما فوق:
ماذا يمنحك: بطاقات RTX PRO، أنظمة multi-GPU، ونماذج ضخمة محليًا بالكامل.
التنازل المعتاد: تعقيد تشغيلي واستهلاك طاقة مرتفع وتكلفة استثمارية باهظة جدًا.
كيف تختار جهازك اليوم؟
إذا كانت أولويتك العملية تتلخص في:
«أريد تشغيل أكبر عدد ممكن من أدوات ومستودعات الذكاء الاصطناعي دون تعقيدات»
← ابدأ بالبحث عن بطاقة NVIDIA بسعة VRAM مناسبة (24GB أو 32GB).
«أريد تشغيل أضخم نموذج ممكن محليًا على جهاز واحد مستقل»
← ابدأ بالبحث عن منظومة ذاكرة موحدة كبيرة (Unified Memory من 128 إلى 512GB).
«أريد الاثنين معًا: سعة ذاكرة ضخمة وتوافق CUDA كامل»
← استعد للدخول مباشرة إلى ميزانيات محطات العمل الاحترافية (Workstations).
وهذا هو التلخيص الأصدق لسوق الحوسبة الشخصية في 2026:
كل فئة من العتاد تزيل قيدًا، وتترك أمامك قيدًا آخر.
فالاختيار السليم ينطلق من تحديد القيد الذي يعيق عملك اليومي فعلًا: هل هو سعة الذاكرة، أم سرعة التوليد، أم التوافق البرمجي؟