هل أصبح كلود أغبى؟ ربما تبحث عن المشكلة في المكان الخطأ
2026-08-23 · A.F. Sadek
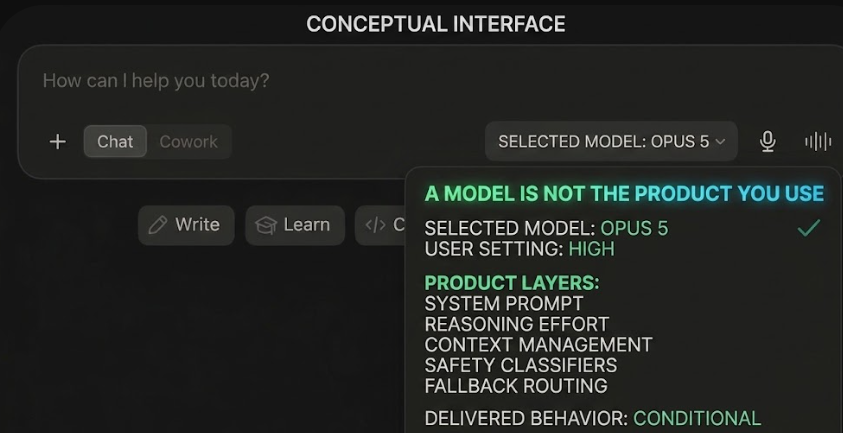
نتائج كلود ترتفع في اختبارات المقارنة، وتجربة كثير من مستخدميه تتحول إلى الأسوء. العبارتان يمكن أن تصحا في الوقت نفسه.
بدأ السؤال عندي من ضيق حقيقي: هل أصبح كلود أغبى؟
هذا هو الوصف الذي يخطر لنا عندما يتغير سلوك المنتج. نطلب منه أن يفحص مشروعًا، فيقفز إلى التعديل قبل أن يقرأ. نعطيه مهمة طويلة، فيتوقف بعد نصفها. نسأله عن رقم، فيقدمه بثقة ثم يتراجع عندما نطلب منه القياس.
كلود لا يملك مزاجًا سيئًا، ومع ذلك تصلنا التجربة بهذه الصورة: كسل، تردد، إسهاب، نسيان، وثقة تسبق الدليل.
كلمة «أغبى» تجمع كل هذه المشكلات في كلمة واحدة. وهي مفهومة، لكنها تخفي السؤال الأهم: أي جزء من النظام تغيّر؟
المستخدمون رصدوا تغيرًا حقيقيًا
منذ بداية 2026، تكررت الشكوى في GitHub وReddit وX. وصف المستخدمون سلوكيات مختلفة: استدلالًا سطحيًا، توقفًا مبكرًا، نسيانًا للسياق، شرحًا طويلًا بلا تنفيذ، اختيارات غريبة للأدوات، وأحكامًا واثقة سبقت التحقق. وبحلول أبريل، وصلت القصة إلى Axios وThe Register.
قدمت ستيلا لورينزو، وهي مديرة بارزة للذكاء الاصطناعي في AMD، واحدة من أكثر الشكاوى تفصيلًا. نشرت في بلاغ على GitHub بتاريخ 2 أبريل تحليلًا لـ6,852 جلسة في Claude Code. شملت البيانات 17,871 مقطعًا من التفكير الظاهر و234,760 مرة استخدم فيها النظام أدواته، ضمن أعمال ثقيلة مثل برمجة النظم، ومشغلات وحدات معالجة الرسوميات، وMLIR، ومهام طويلة تمتد عبر ملفات كثيرة.
الأرقام لافتة:
- كان الطول الوسيط لمقاطع التفكير الظاهرة يقارب 2,200 حرف في نهاية يناير، ثم هبط إلى نحو 600 في منتصف مارس.
- تراجعت نسبة قراءة الملفات إلى تعديلها من 6.6 قراءة لكل تعديل إلى 2.0.
- ارتفعت التعديلات التي جرت من دون قراءة حديثة للملف من 6.2% إلى 33.7%.
- فعّلت أداة آلية ترصد التوقف المبكر والتنصل من إكمال المهمة 173 مرة بعد 8 مارس، مقابل صفر قبل ذلك.
هذه أرقام من بيئة مستخدم واحد، خلال فترة تغيرت فيها المهام وإصدارات المنتج. كما أن جزءًا من عمق التفكير قُدّر بمؤشرات بديلة بعدما حجبت Anthropic مقاطع التفكير. لذلك تمنحنا الدراسة دليلًا قويًا على تغير سلوك النظام في هذه البيئة، وتترك حجم المشكلة عند بقية المستخدمين مفتوحًا.
ثم نشرت Anthropic ما حسم الجزء الأهم من النقاش.
ما الذي غيّرته Anthropic؟
في 23 أبريل، أصدرت الشركة تقريرًا فنيًا عن شكاوى الجودة. وجدت ثلاثة أسباب منفصلة:
- خفض جهد التفكير. في 4 مارس، غيّرت Claude Code الإعداد الافتراضي من
highإلىmediumلتقليل زمن الانتظار واستهلاك الرموز. أعطى القرار المستخدمين استجابة أسرع وقدرة أقل. تراجعت الشركة عنه في 7 أبريل. - خلل في إدارة السياق. في 26 مارس، أضافت الشركة تحسينًا للجلسات المستأنفة بعد الخمول. كان يفترض أن يمسح الاستدلال القديم مرة واحدة. الخلل جعله يمسحه بعد ذلك في كل دورة. بدأ كلود يكرر نفسه، وينسى سبب اختياراته، ويستخدم الأدوات بطريقة غريبة. أُصلح الخلل في 10 أبريل.
- تعليمة اختصار أضرت بالجودة. في 16 أبريل، أضيفت تعليمة إلى موجه النظام تطلب ألا يتجاوز النص بين استدعاءات الأدوات 25 كلمة، وألا يتجاوز الرد النهائي 100 كلمة إلا عند الحاجة. كشف اختبار أوسع لاحقًا عن انخفاض قدره 3% في جودة البرمجة لدى Opus 4.6 و4.7. حُذفت التعليمة في 20 أبريل.
قالت Anthropic إن واجهة API والمحرك الذي يشغّل النموذج لم يتأثرا بهذه المشكلات.
هنا تظهر الخلاصة الأساسية: يمكن أن يبقى النموذج الأساسي كما هو، بينما تصبح التجربة التي تصل إلى المستخدم أضعف بدرجة قابلة للقياس.
أنت تستخدم خدمة كاملة
عندما تختار «Claude Opus»، يصل إليك نظام كامل:
- النموذج.
- موجه النظام.
- مستوى جهد التفكير.
- طريقة حفظ السياق واقتطاعه.
- أوصاف الأدوات والصلاحيات.
- الذاكرة المؤقتة.
- أنظمة تصنيف الطلبات من ناحية الأمان.
- التحويل إلى نموذج احتياطي.
- حدود الاستخدام.
- قرارات التكلفة وزمن الاستجابة.
كل طبقة تستطيع تغيير النتيجة. ميزانية تفكير أصغر تدفع النموذج إلى التصرف بسرعة. اقتطاع سيئ للسياق يجعله يعيد عملًا أنجزه. تعليمة اختصار قاسية تحذف خطوات يحتاجها لإكمال المهمة. نظام أمان واسع يحجب طلبًا سليمًا قبل أن يبدأ العمل.
اسم النموذج يصف المحرك. أما الخدمة فتحدد ظروف تشغيله.
لهذا تفشل حجة «الاختبارات تتحسن، إذن تجربة المستخدم تتحسن» في ملامسة المشكلة. اختبار المقارنة يقيس نموذجًا داخل بيئة محددة. المستخدم يتعامل مع خدمة تتغير تحت ضغط التكلفة، والسرعة، والسياق، والسلامة.
يمكن أن يسجل Opus 5 نتيجة أعلى من سابقه، ثم يقدم أداء أسوأ في مهمة بعينها لأن المنتج منحه جهدًا أقل أو حذف جزءًا مهمًا من سياقه. كل جملة هنا تصف مستوى مختلفًا من النظام.
Opus 5 يوضح الفجوة
قدمت Anthropic نموذج Claude Opus 5 بوصفه متقدمًا في اختبارات البرمجة والعمل المعرفي، وأكثر حرصًا ومبادرة وكفاءة من سابقه. كما شرحت أدوات التحكم في جهد التفكير، وأنظمة الأمان، والتحويل التلقائي إلى Opus 4.8 عندما يرفع نظام الأمان إشارة خطر.
هذه التفاصيل مهمة. الاسم الظاهر في قائمة اختيار النموذج يقدم جزءًا من القصة. قد يبدأ الطلب مع Opus 5، ثم يتدخل نظام أمان أو مسار بديل. وقد يعمل النموذج نفسه بميزانية تفكير مختلفة من جلسة إلى أخرى.
استمرت الشكاوى بعد الإطلاق:
- وثق بلاغ في أغسطس جلستين طويلتين استمر فيهما الوكيل في استخدام الأدوات لساعات مع قدر شبه معدوم من الشرح المرئي. ظل العمل جاريًا، وبقي المشرف البشري عاجزًا عن معرفة ما يحدث.
- وصف مستخدم آخر توصيات واثقة صدرت قبل القياس، ثم تراجع كلود عنها بعد أن وافق المستخدم عليها.
- سجل بلاغ ثالث حظر طلب عادي في الهندسة الميكانيكية ثماني مرات خلال ساعتين تقريبًا بسبب نظام الأمان في Opus 5.
تظل هذه بلاغات فردية. قيمتها أنها تقدم وقائع قابلة للفحص، وحدودها أنها لا تقيس تجربة جميع المستخدمين. ويمنحنا تقرير أبريل سببًا لأخذها بجدية: تقييمات Anthropic الداخلية أخفقت في البداية في إعادة إنتاج مشكلات كان المستخدمون يرونها بالفعل.
أين تدخل السياسة؟
هناك سؤال آخر يحيط بالقصة: هل زاد حذر كلود بسبب التوتر بين Anthropic والحكومة الأمريكية؟
في فبراير 2026، وصلت مفاوضات الشركة مع وزارة الحرب الأمريكية إلى أزمة حول شرطين أصرت عليهما Anthropic: منع استخدام نماذجها في المراقبة الجماعية الداخلية، ومنع استخدامها في الأسلحة المستقلة بالكامل. وفي 4 مارس، صنفت الوزارة الشركة خطرًا على سلسلة الإمداد. طعنت Anthropic في القرار، وأكد داريو أمودي في بيانه الصادر يوم 5 مارس استمرار دعم الشركة لاستخدامات مثل تحليل الاستخبارات، والنمذجة والمحاكاة، والتخطيط العملياتي، والعمليات السيبرانية.
ثم جاءت ضربة مدرسة شجرة طيبة الابتدائية في ميناب خلال الحرب على إيران. قُتل أكثر من مئة طفل. وأعادت وكالة أسوشيتد برس بناء الأدلة التي تشير إلى ضربة أمريكية، بينما ظل البنتاجون يحجب نتائج تحقيقه عن الجمهور.
لا يوجد دليل علني يثبت أن كلود اختار هذا الهدف، أو أن مخرجًا منه تسبب في الضربة، أو أن Anthropic عدّلت سلوكه اليومي ردًا على الواقعة. هذه نقطة تستحق النفي الصريح لأن القفز من التزامن إلى السببية سيكرر الخطأ الذي ننتقده: حكم واثق قبل التحقق.
في يونيو، اتسع دور الحكومة في نشر النماذج المتقدمة. أعلنت Anthropic تلقي توجيه أمريكي بتعليق وصول الرعايا الأجانب إلى Fable 5 وMythos 5. وفي الشهر نفسه، طلبت الإدارة من OpenAI أن تبدأ إطلاق GPT-5.6 مع مجموعة صغيرة من الشركاء المعتمدين، وفق تقرير Axios.
السياق السياسي يشرح البيئة التي تُبنى فيها طبقات الأمان والتوجيه ومسارات الوصول. أما تراجع أبريل التقني فله أسباب موثقة داخل المنتج: إعداد جهد، وخلل في السياق، وتعليمة في موجه النظام.
من حقنا أن نسأل عن أثر السياسة في تصميم المنتج. وتحتاج الإجابة إلى أدلة تربط قرارًا سياسيًا بتغيير تقني محدد.
التشخيص الأدق: الذكاء المنشور
السؤال المفيد إذن هو: كم يصل إلى المستخدم من قدرة النموذج، وتحت أي شروط؟
قد يملك النموذج القدرة على قراءة المشروع بعمق، ثم تمنحه الخدمة ميزانية أصغر. وقد يفكر جيدًا، ثم يحذف نظام السياق جزءًا من تفكيره. وقد يفهم الطلب، ثم يوقفه نظام أمان خارجي أو يرسله إلى نموذج آخر.
هذه كلها تغييرات في الذكاء المنشور: الذكاء الذي يصل إلى المستخدم بعد أن يمر عبر طبقات المنتج.
لهذا أريد من Anthropic سجل تغييرات يعامل الأمور الآتية كجزء من جودة المنتج:
- تعديلات موجه النظام.
- الإعداد الافتراضي لجهد التفكير.
- سياسات حفظ السياق واقتطاعه.
- أنظمة الأمان.
- التحويل إلى نماذج احتياطية.
- المقايضة بين التكلفة والسرعة وعمق التفكير.
وأريد تقييمات للنسخة العامة التي يستخدمها الناس، مع توضيح النموذج الذي أجاب الطلب، وسبب تدخل نظام السلامة، وأي مسار بديل استُخدم.
تحتاج الحكومات إلى القدر نفسه من الشفافية حول موقع هذه الأنظمة داخل سلاسل القرار العملياتي. عبارة «الإنسان مسؤول» تحدد صاحب المسؤولية، وسجل التدقيق يوضح كيف وصل القرار إليه.
فهل أصبح كلود أغبى؟
الإجابة المختصرة: تجربة كلود ضعفت في فترات محددة، ولدينا الآن دليل مباشر على أن طبقة المنتج سببت جزءًا مهمًا من هذا الضعف.
اسم النموذج وحده لا يشرح ما نراه. كلود الذي نستخدمه كل يوم هو حاصل ضرب القدرة، والميزانية، والسياق، والتوجيه، والسلامة، وطريقة عرض العمل. أي خلل في عامل واحد يخفض الناتج كله.
الذكاء الذي تبيعه الشركات أصبح مشروطًا بإعدادات لا يراها المستخدم: موجه خفي، وميزانية تفكير، وحالة ذاكرة مؤقتة، ونظام أمان، وقرار توجيه، وبيئة سياسية وتنظيمية سريعة التغير.
نتيجة اختبار المقارنة ظاهرة على الرسم البياني. حان الوقت لأن تصبح شروط الذكاء ظاهرة أيضًا.
المصادر وقراءات إضافية
- Anthropic، «تحديث حول تقارير جودة Claude Code الأخيرة»، 23 أبريل 2026.
- Anthropic، «تقديم Claude Opus 5»، 24 يوليو 2026.
- ستيلا لورينزو، بلاغ Claude Code رقم 42796، 2 أبريل 2026.
- Axios، «تراجع Anthropic يؤلم المستخدمين المحترفين»، 16 أبريل 2026.
- The Register، «كلود يزداد سوءًا، وفقًا لكلود»، 13 أبريل 2026.
- Anthropic، «إلى أين وصلت الأمور مع وزارة الحرب»، 5 مارس 2026.
- Associated Press، إعادة بناء ضربة مدرسة ميناب، 1 يوليو 2026.
- Anthropic، بيان حول قيود الوصول إلى Fable 5 وMythos 5، 12 يونيو 2026.
- Axios، «إدارة ترامب تطلب من OpenAI تقييد إطلاق نموذجها التالي»، 25 يونيو 2026.